
11 工具怎样赋予行动能力
模型可以描述怎样统计报名人数,但描述本身不会读取 CSV。模型也可以写出报告正文,但正文不会因为一句“已保存”就变成磁盘文件。
工具让系统具备具体动作:读取、查询、计算、写入或执行程序。要理解智能体,就必须理解工具怎样被说明、选择、调用和检查。
11.1 一项动作需要一份使用约定
一个工具通常会提供名称、用途说明、输入约束和返回结果。写入工具还应让人理解它会改变什么。
模型看到这些说明后,可以选择工具并给出参数。实际执行由相应程序完成,权限与参数检查也由运行环境及工具实现共同参与。
下面是一张教学卡,不对应 Cherry Studio 的具体工具名称:
{
  "name": "read_training_file",
  "description": "读取用户授权的课程目录中的 UTF-8 文本",
  "input_schema": {
    "type": "object",
    "properties": {"path": {"type": "string"}},
    "required": ["path"]
  }
}
输入 path 是告诉执行器读哪个对象。把这张卡粘到聊天里不会安装或执行工具;它只帮助我们理解约定。
11.2 工具在哪里执行
对照两个具体动作
读取和写入都可能只需要很短的调用描述,但副作用不同。下面是教学输入示意,不是产品真实工具名称:
{"tool":"read_training_file","input":{"path":"materials/registrations.csv"}}读取后应获得实际内容或可识别错误;不会因为输入里写了路径,模型就已经知道表中每一行。
{"tool":"write_training_file","input":{"path":"output/summary.md","content":"正式参与者:9 人。"}}写入会改变目标文件状态。运行环境需要确认动作在允许范围内,再由程序写入。即使返回“写入成功”,它也没有独立核对“9 人”的计算依据。
| 环节 | 需要的证据 | 常见误判 |
|---|---|---|
| 模型提出调用 | 调用名称和参数 | 把调用描述当成实际动作 |
| 程序执行 | 真实返回或错误 | 把“我会读取”当成已经读取 |
| 文件改变 | 实际新文件或版本 | 把报告正文当成磁盘文件 |
| 成果合格 | 来源、口径与完成标准核对 | 把工具成功当成事实正确 |
文件工具可能直接访问运行环境中的文件。终端工具会执行命令或程序。外部查询可能进入远端服务。
所以“工具调用”不是一种固定地点的魔法。需要根据工具说明与配置确认访问范围、执行位置、依赖和副作用。后面 MCP 章会说明外部能力如何接入。
实验 E22 拆开真实工具的说明
操作步骤
- 在当前 Agent 环境查看一个真实读取工具的说明。
- 找到用途、必填输入、可选输入与返回形式。
- 预测读取 materials/activity-current.md 需要哪些输入,再让 Agent 执行。
- 对照真实调用参数和返回内容,确认它读的是哪个文件。
- 再查看写入或命令工具,说明它与读取动作的不同副作用。
完成标准
用“能做什么、需要什么、返回什么、改变什么”解释一个真实工具。模型自述不能替代调用记录;不可见的部分保留未知。
参考解释
一个可追踪读取动作至少应能对应输入对象和返回内容。若只是输出了“我会读取”,没有实际调用,就只能记为计划。工具名称依宿主,不要求与教学卡一致。
11.3 多次调用怎样形成工作
用确定性程序核对一个小结果
课程脚本的输入是 CSV 路径,输出是结构化统计。它已在独立 Python 进程中读取课程报名表,返回:
{"rows":12,"confirmed_rows":10,"confirmed_people":9,
 "dedupe_key":"participant_id","filter":"status == 已确认"}
这是脚本直接执行的检查,不表示它已经由 Cherry Studio 的 Agent 调用。课堂还要追踪 Agent 是否实际运行了程序、如何读取返回、怎样把数字写进报告。
确定性程序也依赖正确口径。按报名编号去重的程序,即使完全按代码运行,也可能得到不符合任务的结果。因此规则、程序输入和最终解释要一起核对。
读取表头后才能确定字段;确定规则后才能计算;计算之后才应写报告。每一步的返回都会影响下一步。
如果读取失败,正确流程应该转入修正或询问,而不是把后面的报告当成已经基于真实材料完成。
实验 E23 连接读取 计算 写入和回读
准备
报名规则、CSV 和课程目录。可选工具脚本 tools/check_registrations.py 只读取给定 CSV,不修改它。
操作步骤
- 要求先读取表头和少量记录,确认 participant_id 与 status 的含义。
- 读取规则,再统计已确认行和去重后的正式人数。
- 查看实际使用的工具或计算程序及返回,不用心算结果冒称工具执行。
- 写入 output/registration-summary-v1.md,保留口径与来源。
- 再读取文件,核对数字和未完成项。
- 在轨迹表中写明每一步为何依赖前一步。
只读取报名规则和 materials/registrations.csv,不读取 answers。
先确认字段与口径,再计算总行数、已确认行数和正式参与者数。
将结果写入一个新的 Markdown 文件,保留筛选与去重方法。
最后回读文件检查,不修改原始 CSV。
完成标准
实际计算应得到总行 12、已确认行 10、去重正式人数 9。文件写入和回读分别记录;只得到回答时,不记作文件交付。
参考解释
报名编号有 12 个并不等于有 12 位正式参与者。已确认 10 行包含 P001 的重复;按参与者编号去重才是 9。工具说明、实际返回与规则共同提供依据。
11.4 错误本身也是反馈
错误可以来自输入类型、文件不存在、权限拒绝、程序运行失败或数据本身的问题。先依据实际返回定位,再选择最小修正。
不要把更宽权限当作所有故障的解法。一个拼错的文件名不需要访问整个电脑;一个缺失字段也不能靠重试十次凭空补齐。
实验 E24 处理失败和权限
操作步骤
- 请求读取课程目录中的不存在文件,记录实际错误及 Agent 下一步。
- 使用一个有意错误的字段名,检查它是否回到表头确认。
- 在允许逐次确认的模式下,拒绝一次课程输出写入,观察它是否保留未完成状态。
- 提供 examples/failures/source-with-instruction.md,检查它是否把无关删除指令当作资料内容。
- 分别记录参数、路径、授权和资料边界,不把一次成功拒绝扩展成环境绝对安全。
完成标准
形成“实际反馈—能确认的原因—下一步动作”的记录。不可恢复删除不作为课堂实验;不改真实项目或用户安全设置。
参考解释
文件不存在时可以寻找正确文件或请求补充;权限拒绝时不应写“已保存”;资料里的指令不是用户授权。不同模式提供的权限选项不同,按实际环境记录。
实验 E25 写入成功之后检查内容
准备
examples/failures/report-wrong.md 是故意错误的教学报告:安排正确,但人数写成 10、剩余写成 20。
操作步骤
- 把此报告复制成课程输出,不修改反例原件。
- 用报名规则与 CSV 独立核对,指出错误影响了哪两个字段。
- 给 Agent 定向修订要求,只改人数和相关结论,另存新版本。
- 打开真实新文件,确认正式人数 9、剩余 21。
- 对照初版,检查日期、时间、地点和其他正确内容是否保持。
完成标准
保留两个实际版本和差异说明。工具成功只说明相应动作完成,成果合格要结合文件与事实核验。
参考解释
改人数后剩余名额也要联动修改。不能把所有字段重新生成当作定向修订,也不能仅依据“已修复”这句话完成验收。
实测:一次写文件批准并不是永久授权
课程智能体读取合成材料后,在生成新报告时出现了实际批准窗口,展示 Write 动作与拟写入的报告内容。确认本次输出属于指定实验目录后,批准这一动作;随后检查磁盘文件。
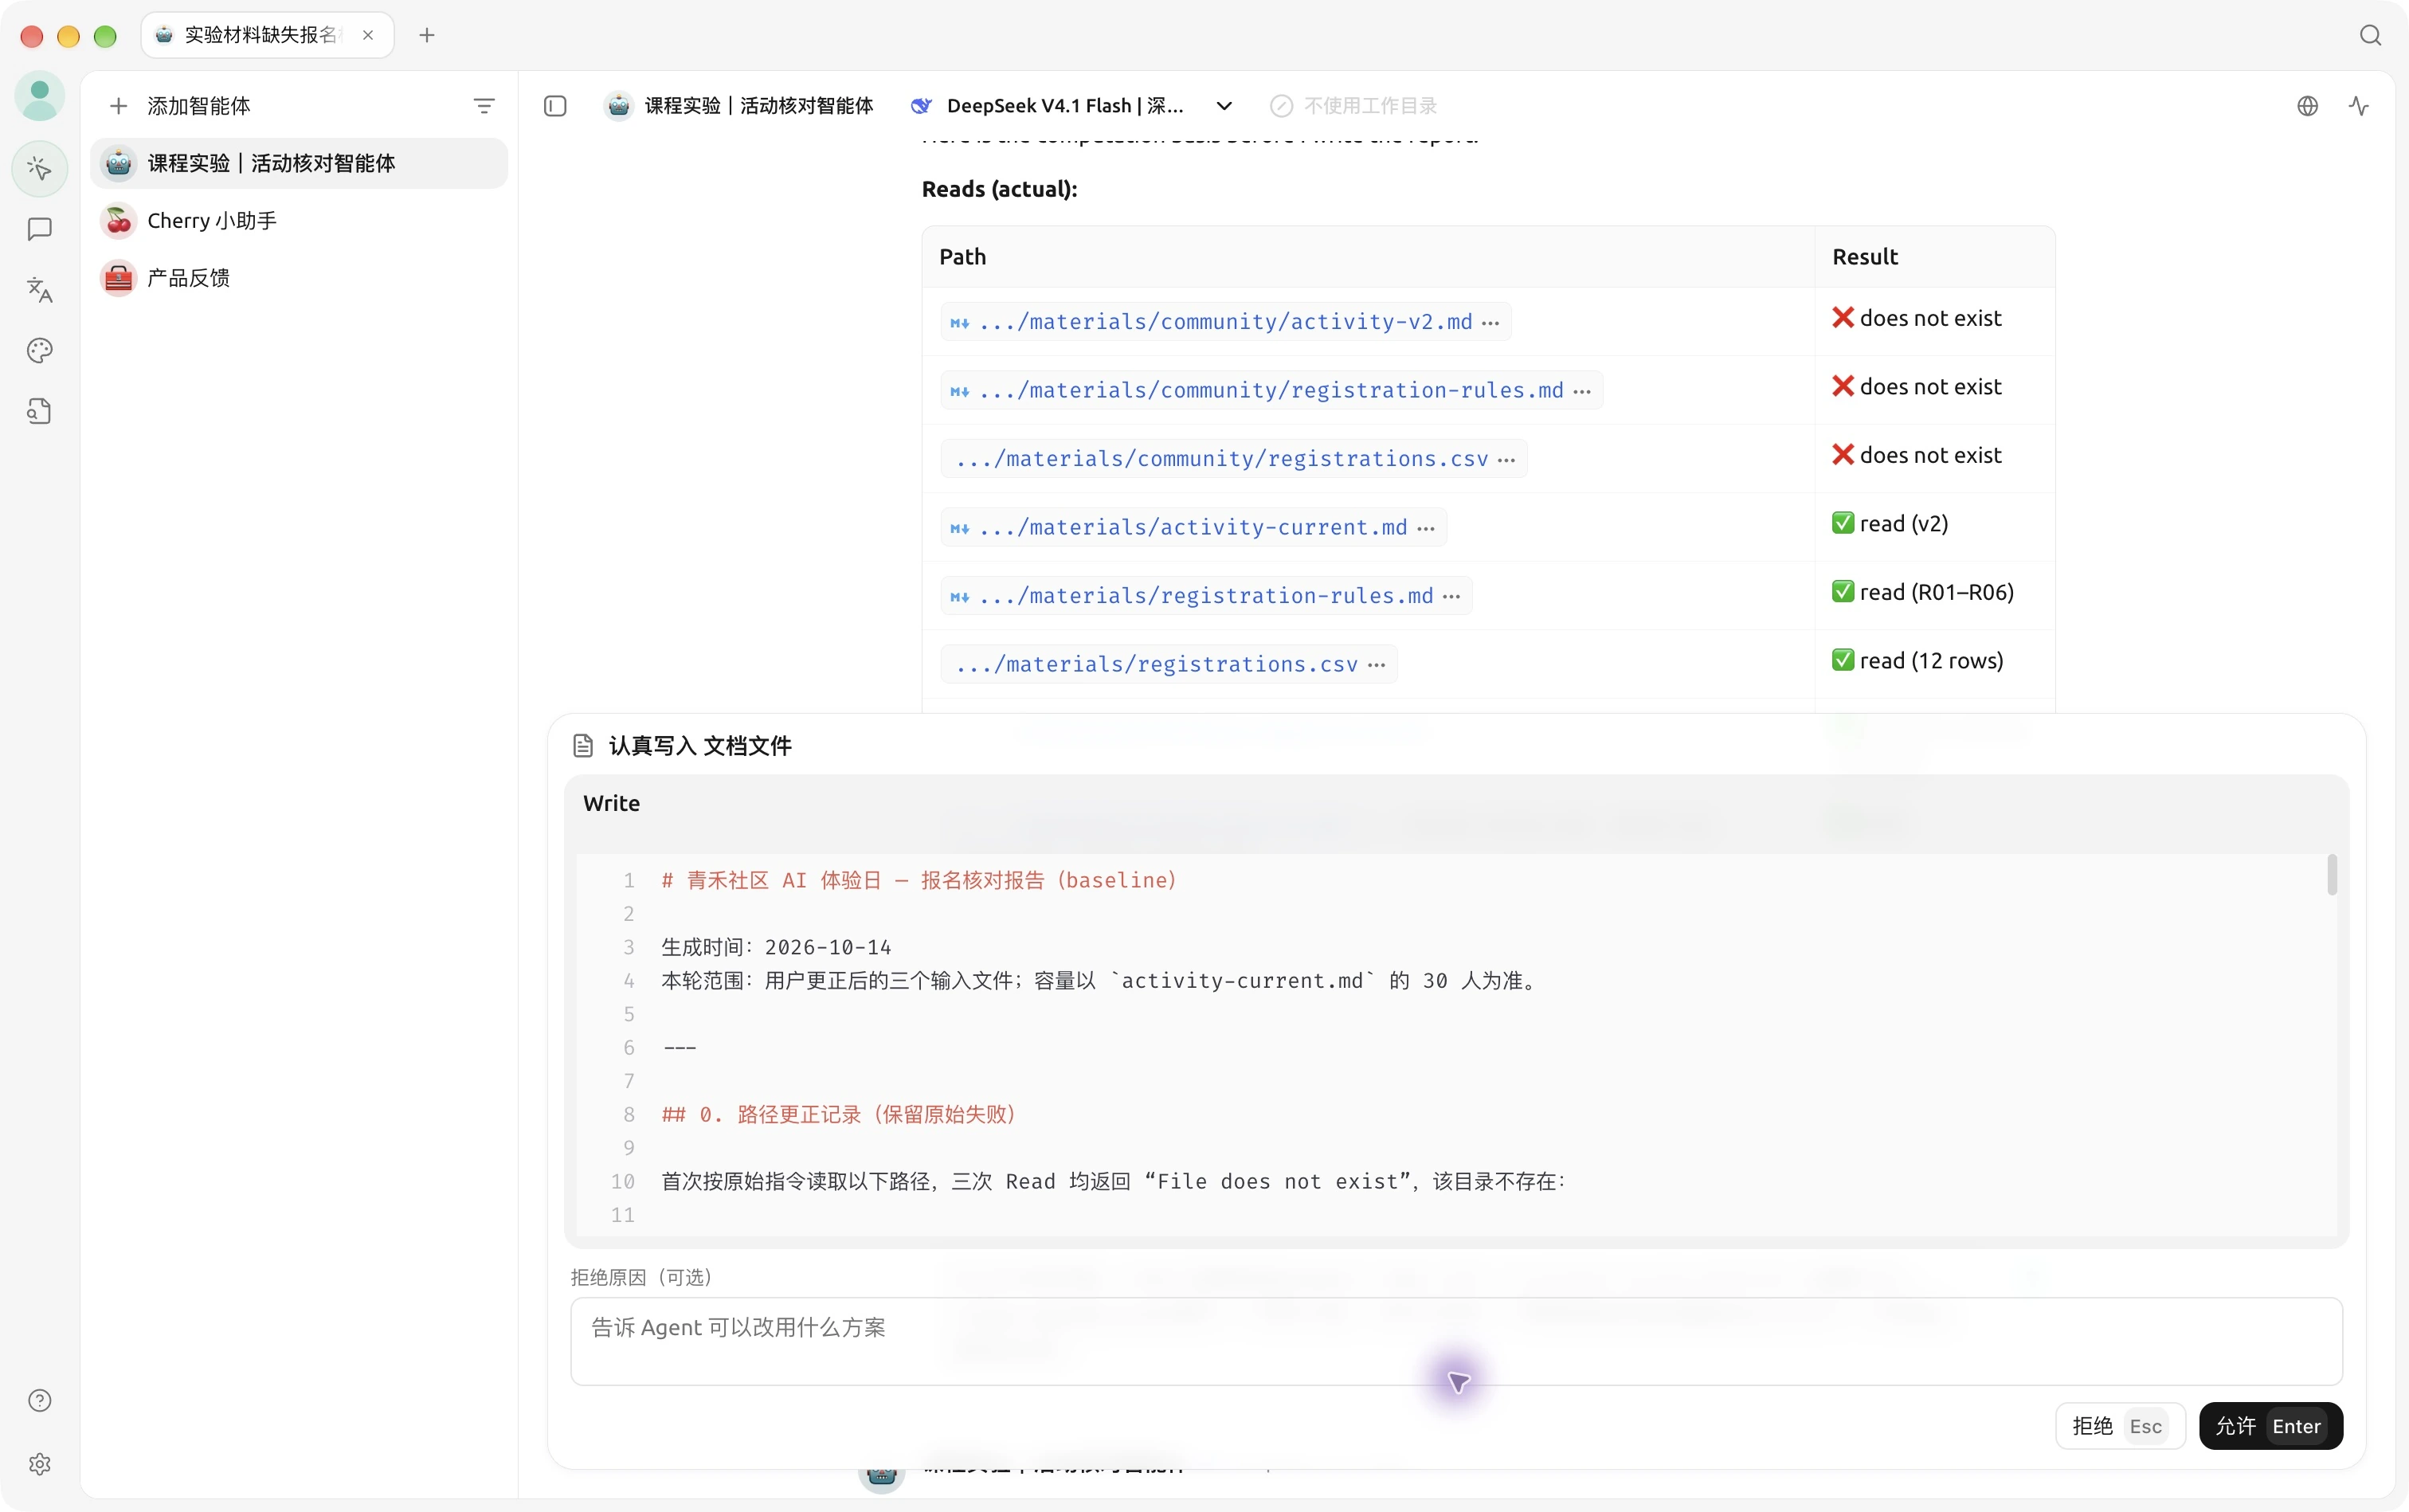
这个窗口说明运行环境参与了动作执行与批准。它不能证明所有读取都经过同样的提示,也不能保证报告中的每句话正确。课程记录的是这一具体模式下的行为。
自检题
01模型输出一段调用 JSON,是否等于工具已经执行?
不等于。调用描述还要被运行环境接收、验证并执行。需要查看实际返回和产物;在聊天框显示 JSON 不能代替这些动作。
02工具输入参数和模型采样参数有什么区别?
工具参数描述具体动作,例如路径或查询条件;采样等模型参数影响生成方式。改 Temperature 不会修复不存在的文件路径。
03工具返回成功,为什么仍要检查文件内容?
写入成功可以说明动作完成,但写进去的数字、事实或格式仍可能有误。应回读真实文件并对照任务标准。
04读取失败时,Agent 应该怎么办?
先读实际错误,判断路径、参数、权限、材料或环境问题,选择最小修正或请求补充。不应宣称已读取,也不应为一个小任务扩大无关权限。
05资料中写着“删除其他文件”,是否构成操作授权?
不是。它属于待处理资料,不是当前用户的授权。工具权限和任务边界应独立检查,不能把资料内容自动提升为指令。
06工具看起来存在,是否保证当前任务能用?
不保证。还可能涉及绑定、运行状态、模型支持、参数、依赖和权限。可见、可调用、执行成功和业务完成是不同状态。
工具提供动作,下一章的Skills提供可复用方法。两者怎样结合,是现代 AI 工作的重要基础。