
07 Token 与上下文
你在同一个话题里说“地点改成 301 室”,后面追问时,模型采用了新地点。另开一个话题问“活动在哪里”,它却可能不知道你指哪一场。
这两种表现帮助我们理解上下文:模型这一轮根据什么信息回答。不要急着把“记得”解释成永久学习,也不要把“忘了”解释成模型完全没有相关能力。
7.1 Token 是处理单位
文本通常先转换为 Token 序列,供模型处理。Token 可能对应字、词片段、标点或其他编码单位,具体切法依分词器而变。
例如,同样长度的中文、英文和程序代码,Token 数可能不同。不要用“多少字一定多少 Token”统一计算所有输入。知道编号或数量,也不等于理解了这段话的全部意义。
应用可能显示估算,服务也可能返回用量统计。两者都可以记录,但要写明来源;输入、输出、缓存或推理相关用量的口径以服务为准。
7.2 本轮上下文不只是输入框
固定要求、当前问题、选入的历史、文件或检索内容,都可能参与本轮输入。后面进入 Agent 时,还会看到工具说明和工具结果。
你脑海里的背景不自动进入上下文。把文件放在某个目录里,也不证明模型读取了它。模型自称知道某个事实,仍需要核对实际来源。
7.3 对话保存与历史选入不同
本课程在 2.1.6 中用同一助手、同一模型和完全相同的问题做了对照。校园话题已有 campus-v1 材料时,回答是 B205、12 人;新话题没有活动材料时,回答保留未知。第二个回答没有严格遵守“两行简短回答”的形式要求,这也说明来源判断与格式遵守需要分别检查。
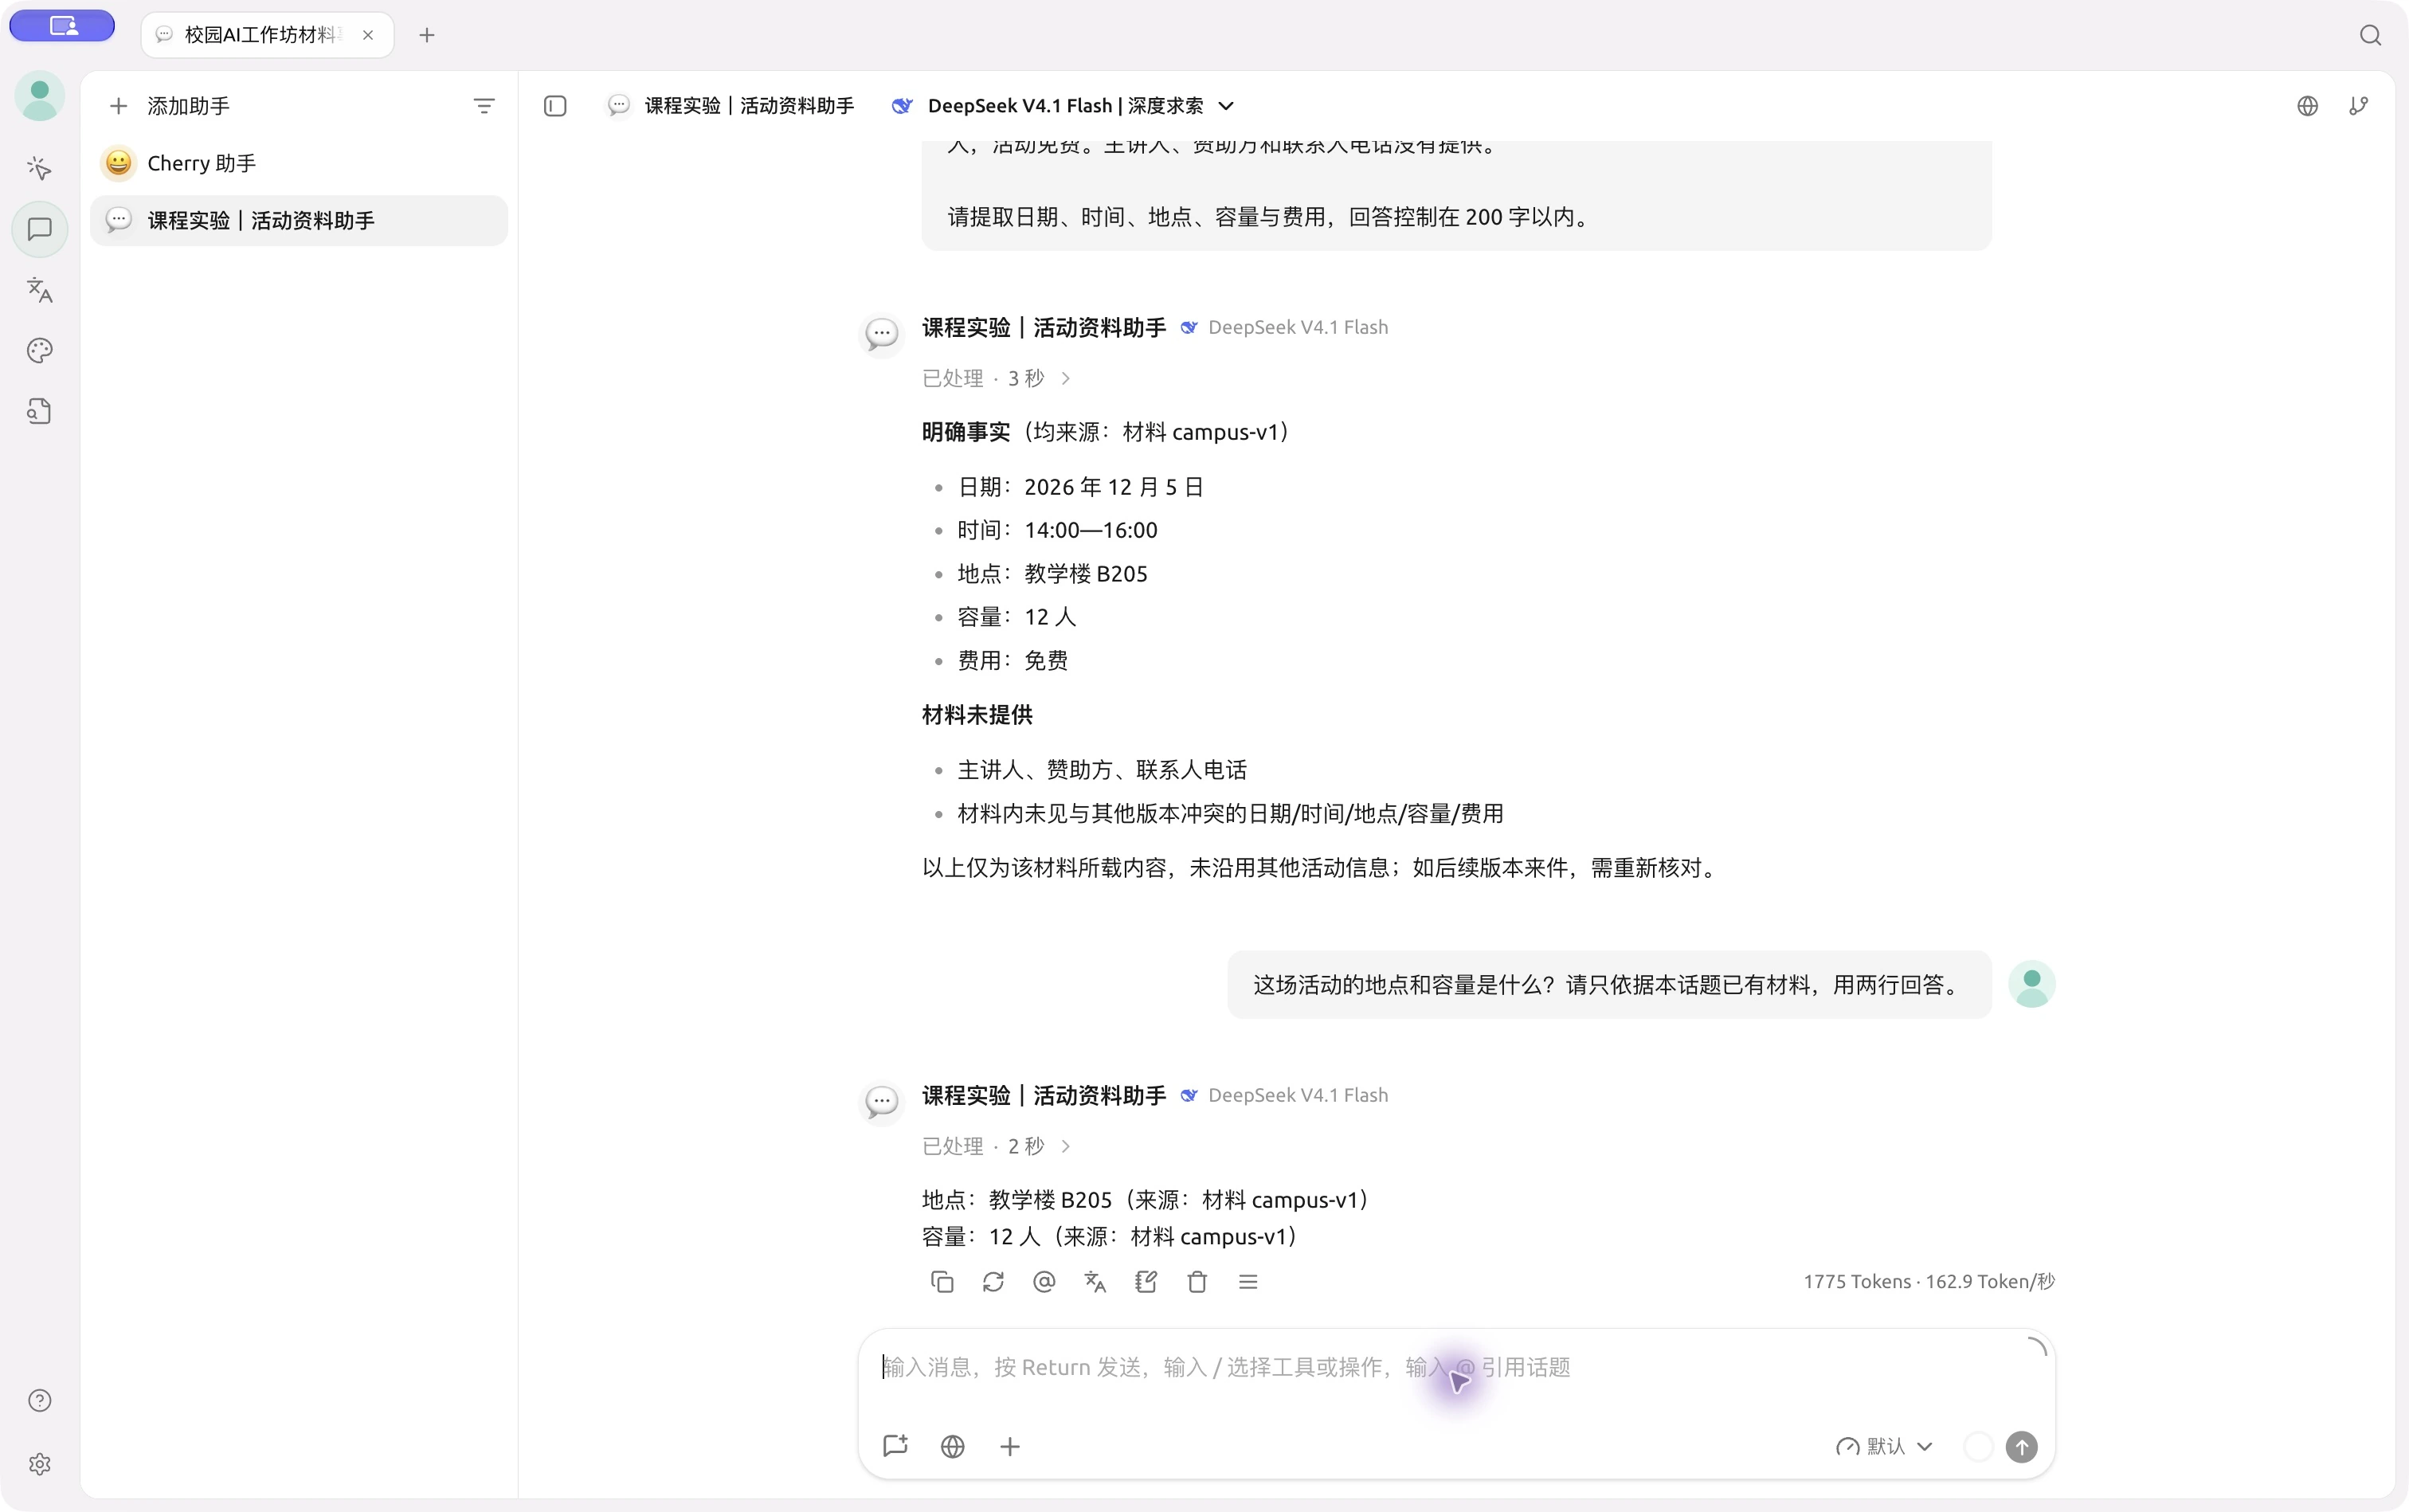
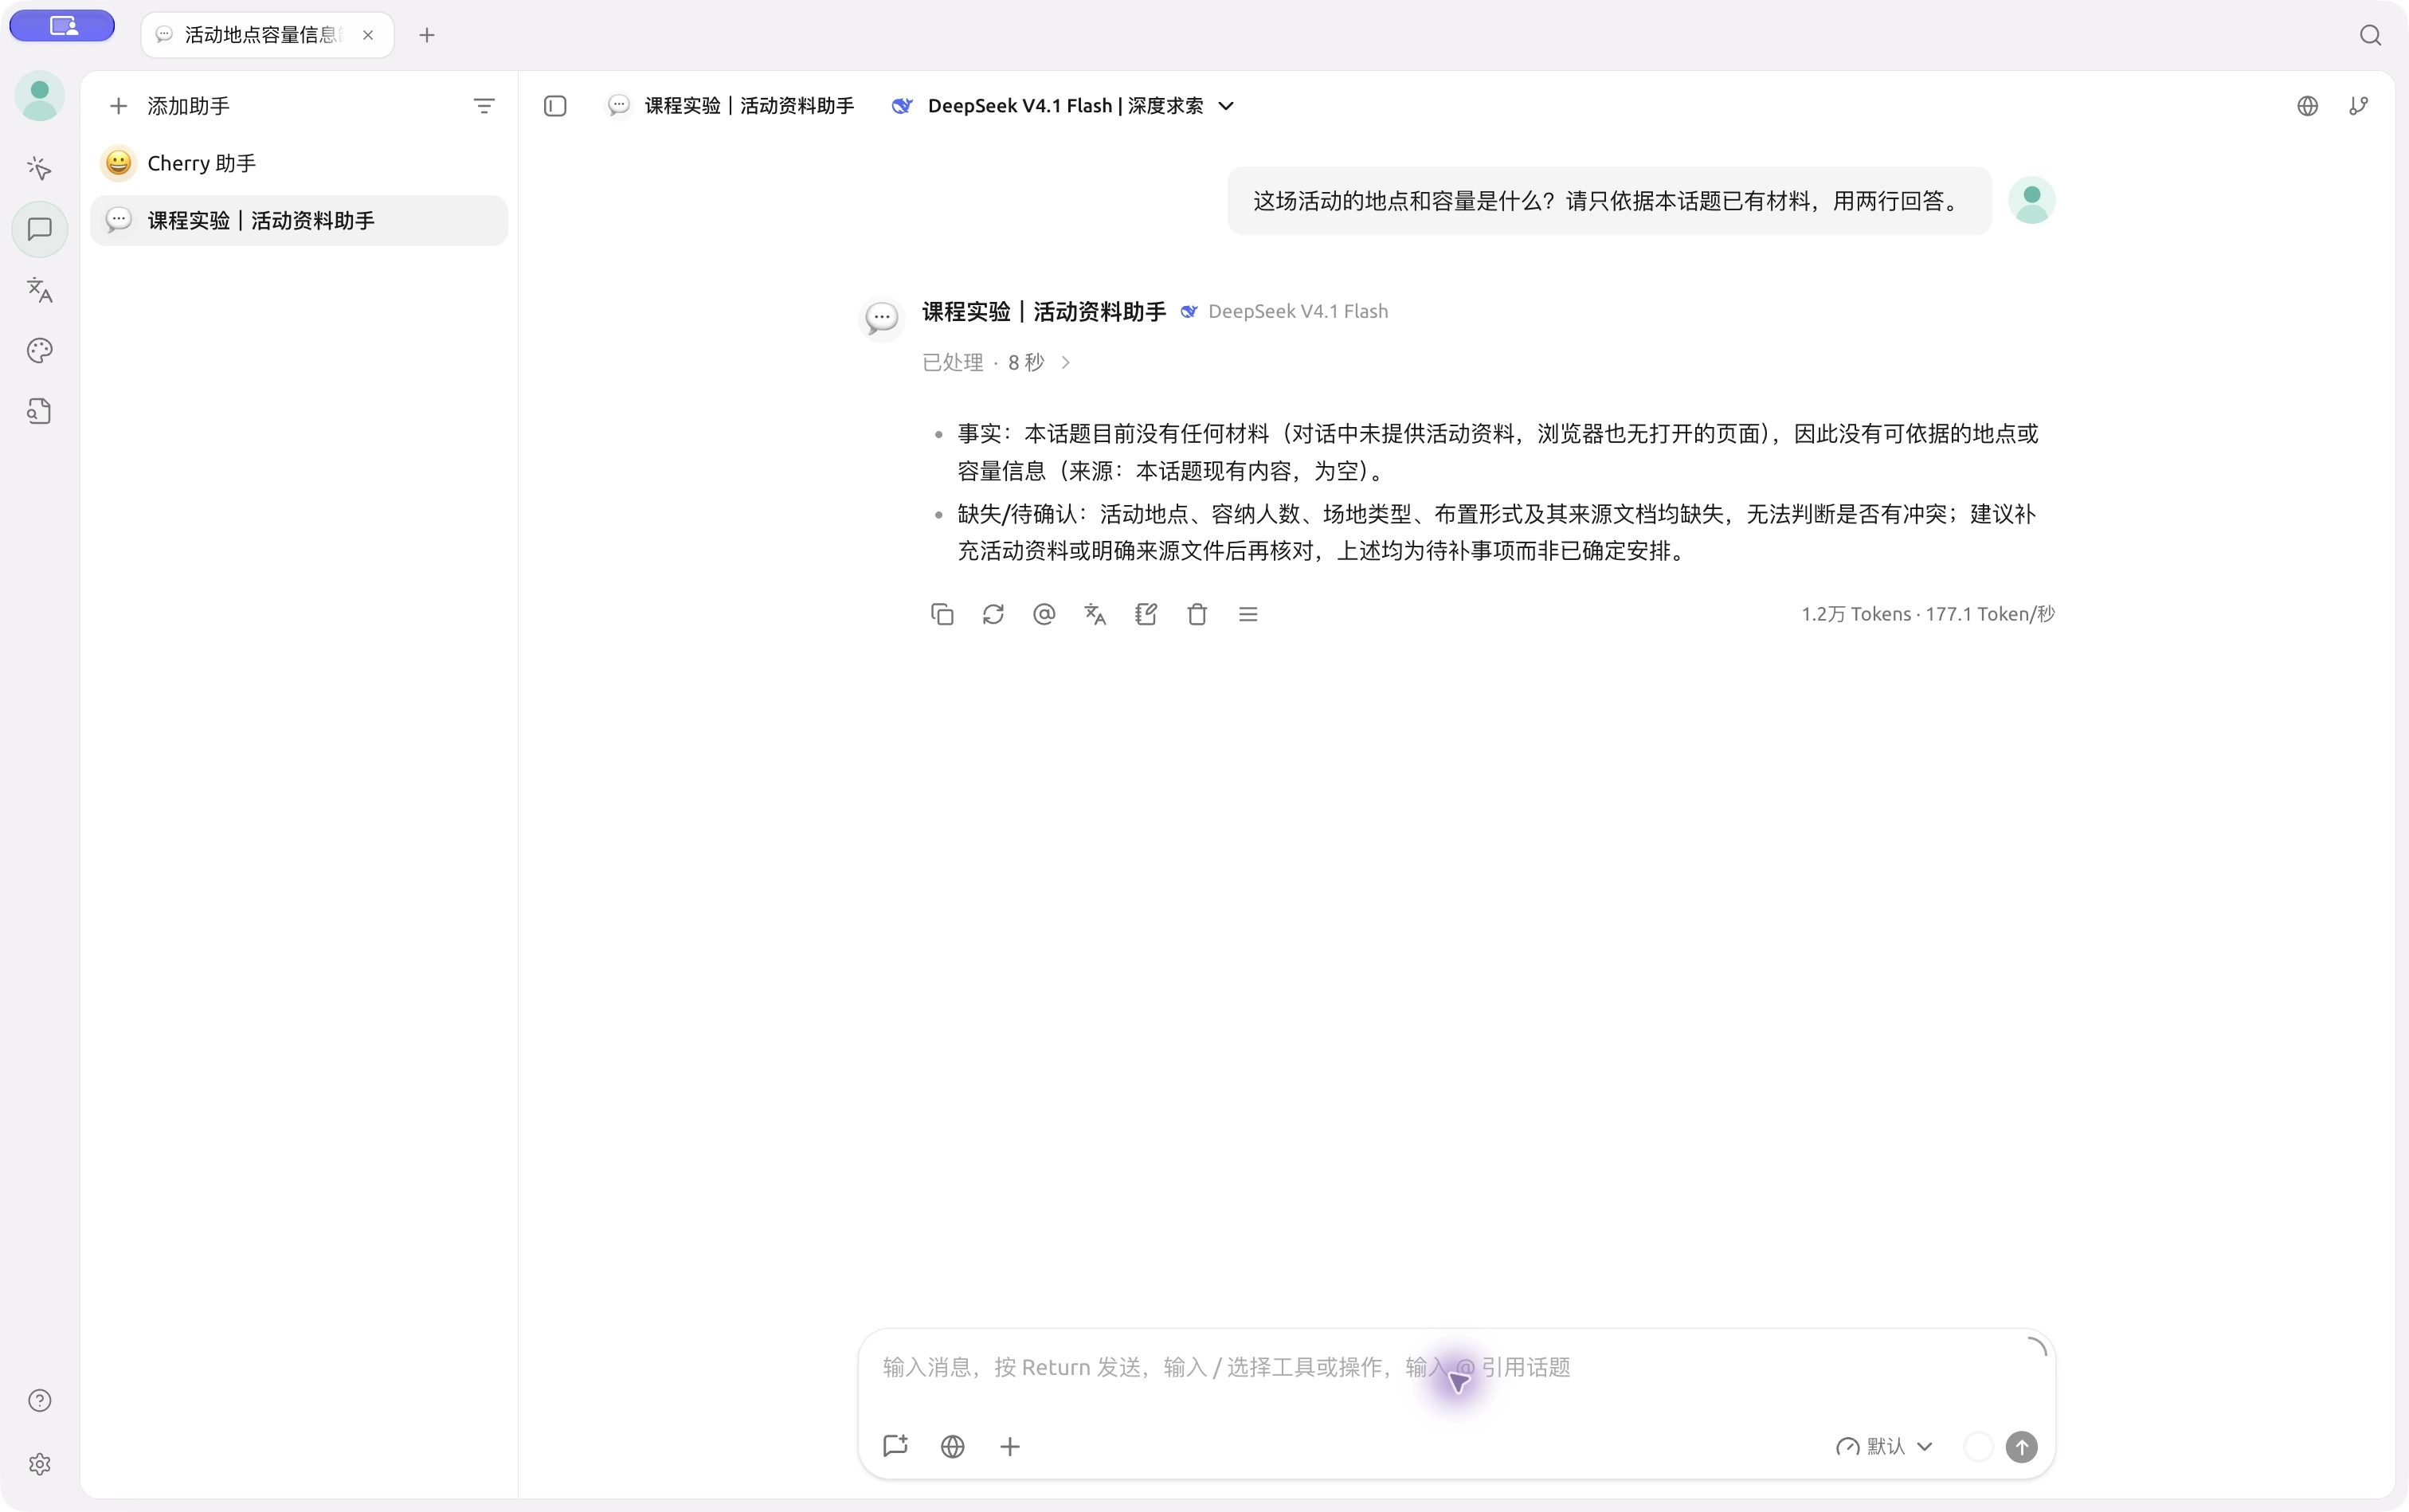
应用保存历史,便于人继续查看。组织模型请求时,它可能只选择相关或最近的消息,也可能用摘要代替较早内容。
因此,一个很久以前的关键限制即使还在聊天记录里,也未必以原文形式参与当前回答。需要保留的事实和边界,应明确组织为材料或交接说明。
当前官方文档介绍了助手的历史保留和上下文压缩设置。使用时先观察需求,不为实验修改所有日常助手的全局设置。长对话与上下文管理
7.4 窗口有限 信息还会竞争
上下文窗口限制一次请求能处理的信息规模,具体口径取决于模型和接口。加入更多材料可能有帮助,但重复、无关内容和冲突版本也会增加使用困难。
问一条报名规则时,当前条款和相关例外很重要。大量旧广告即使增加了字数,也不一定增加有用信息。判断应看答案的依据,而不是只看输入是否很长。
实验 E13 比较同一话题与新话题
准备
课程专用助手、同一模型,记录知识库、联网或额外记忆设置。使用两种明确区分的活动材料。
操作步骤
- 在话题 A 先提供社区旧版安排,再明确提供当前 v2,询问当前地点和容量。
- 在同一话题里只问“这场活动在哪里、最多多少人”,观察它怎样利用前文。
- 新建话题 B,不提供材料,问同一个问题。
- 再把当前说明提供给 B,重复提问。
- 将实际输入、回答和来源分开记录;如果 B 猜对了,检查额外资料或其他路径,不倒推必然取回历史。
- 若界面提供 Token 估算或用量,记录来源和数值,不按看到的字数自行冒充服务统计。
请只依据这个话题中实际提供的材料回答。
当前活动在哪里举行,场地容量是多少?
没有材料时请说明缺少什么,不推测活动安排。
完成标准
能解释每次回答获得了哪些明确材料,哪些内部选择不可见。同一话题的表现不能证明永久训练,另开话题的表现也不能单独证明所有应用记忆都被清空。
参考解释
当前社区安排是 301 室、30 人。没有任何对应材料时,合适的处理是保留未知。新话题如果绑定了知识库或其他信息来源,要把它们作为实际输入条件记录。
实验 E14 用摘要接续一个讨论
准备
一段讨论包含初版与修订版、报名规则、明确事实和未决事项。先完成一次小任务,再制作摘要。
操作步骤
- 用“总结一下”形成一份普通摘要,保存原稿。
- 再按下面模板形成结构化交接摘要。
- 回查原文,标出每份摘要遗漏或改变的事实和条件。
- 在两个独立新话题分别提供对应摘要,要求继续写活动通知。
- 对照日期、时间、地点、容量和未知信息,修改摘要后复测。
- 明确这是手工交接实验,不冒称已经测试某种自动压缩算法。
请制作供新话题继续工作的交接摘要,分成:
1. 已确认事实及其来源和版本。
2. 已完成的工作与实际产物。
3. 尚未确定或存在冲突的事项。
4. 不能丢失的要求与边界。
5. 下一步只需要处理的目标。
不要把计划写成已完成动作。
完成标准
交出经过原文核对的摘要和两次接续结果。摘要不是越短越好,而是需要保留接续任务真正依赖的信息。
参考解释
只留下“活动安排已确定”不足以继续工作。应保留 v2 取代 v1、当前四项安排、统计口径和缺失信息。若已经写入某个文件,也要说明实际路径与完成范围。
7.5 把状态与学习分开解释
当前输入改变、应用保存长期信息、模型训练改变参数,是三种不同机制。使用时可以观察产品的信息流,但不应仅凭一次回答断言发生了其中某种内部变化。
自检题
01一个汉字是否一定等于一个 Token?
不是。Token 的划分取决于分词器、语言和文本内容。界面估算与服务返回统计也应分别标明来源,不能把所有模型套进固定换算。
02聊天记录保存了,是否说明每一条都进入本次请求?
不说明。应用可能选择部分历史、截断或压缩,再与固定要求、当前消息和资料一起组织输入。需要关注实际选入的信息。
03聊天中纠正一个事实,是否证明模型参数被训练更新?
不能据此证明。更直接的解释是当前上下文改变了。长期记忆和参数训练是不同机制,需要另外的证据。
04交接摘要只保留结论是否足够?
通常还要保留来源、适用版本、未决问题、限制和已完成动作。只有结论可能漏掉决定正确答案的条件,摘要应回查原材料。
下一章观察文件、图片与网页怎样成为可用输入。长期记忆与任务进度会在第 14 章继续拆开。