
08 文件、图片与网页输入
活动说明可能是 Markdown,报名规则可能在 PDF 中,场地安排可能藏在海报里。把这些资料交给 AI,看起来都叫“添加材料”,处理路线却不一定相同。
这一章关注三层:原始资料是什么,应用把它处理成什么,回答实际采用了哪些信息。沿着这三层核对,能避免把解析错误误认为模型知识不足。
8.1 文档怎样变成可处理的内容
实际的“输入快捷面板”包含上传附件、生成图片、知识库、MCP 提示词和资源等入口。当前截图里的知识库不可选,因为这个实验环境当时还没有可用库;入口存在与任务已经跑通是不同事实。
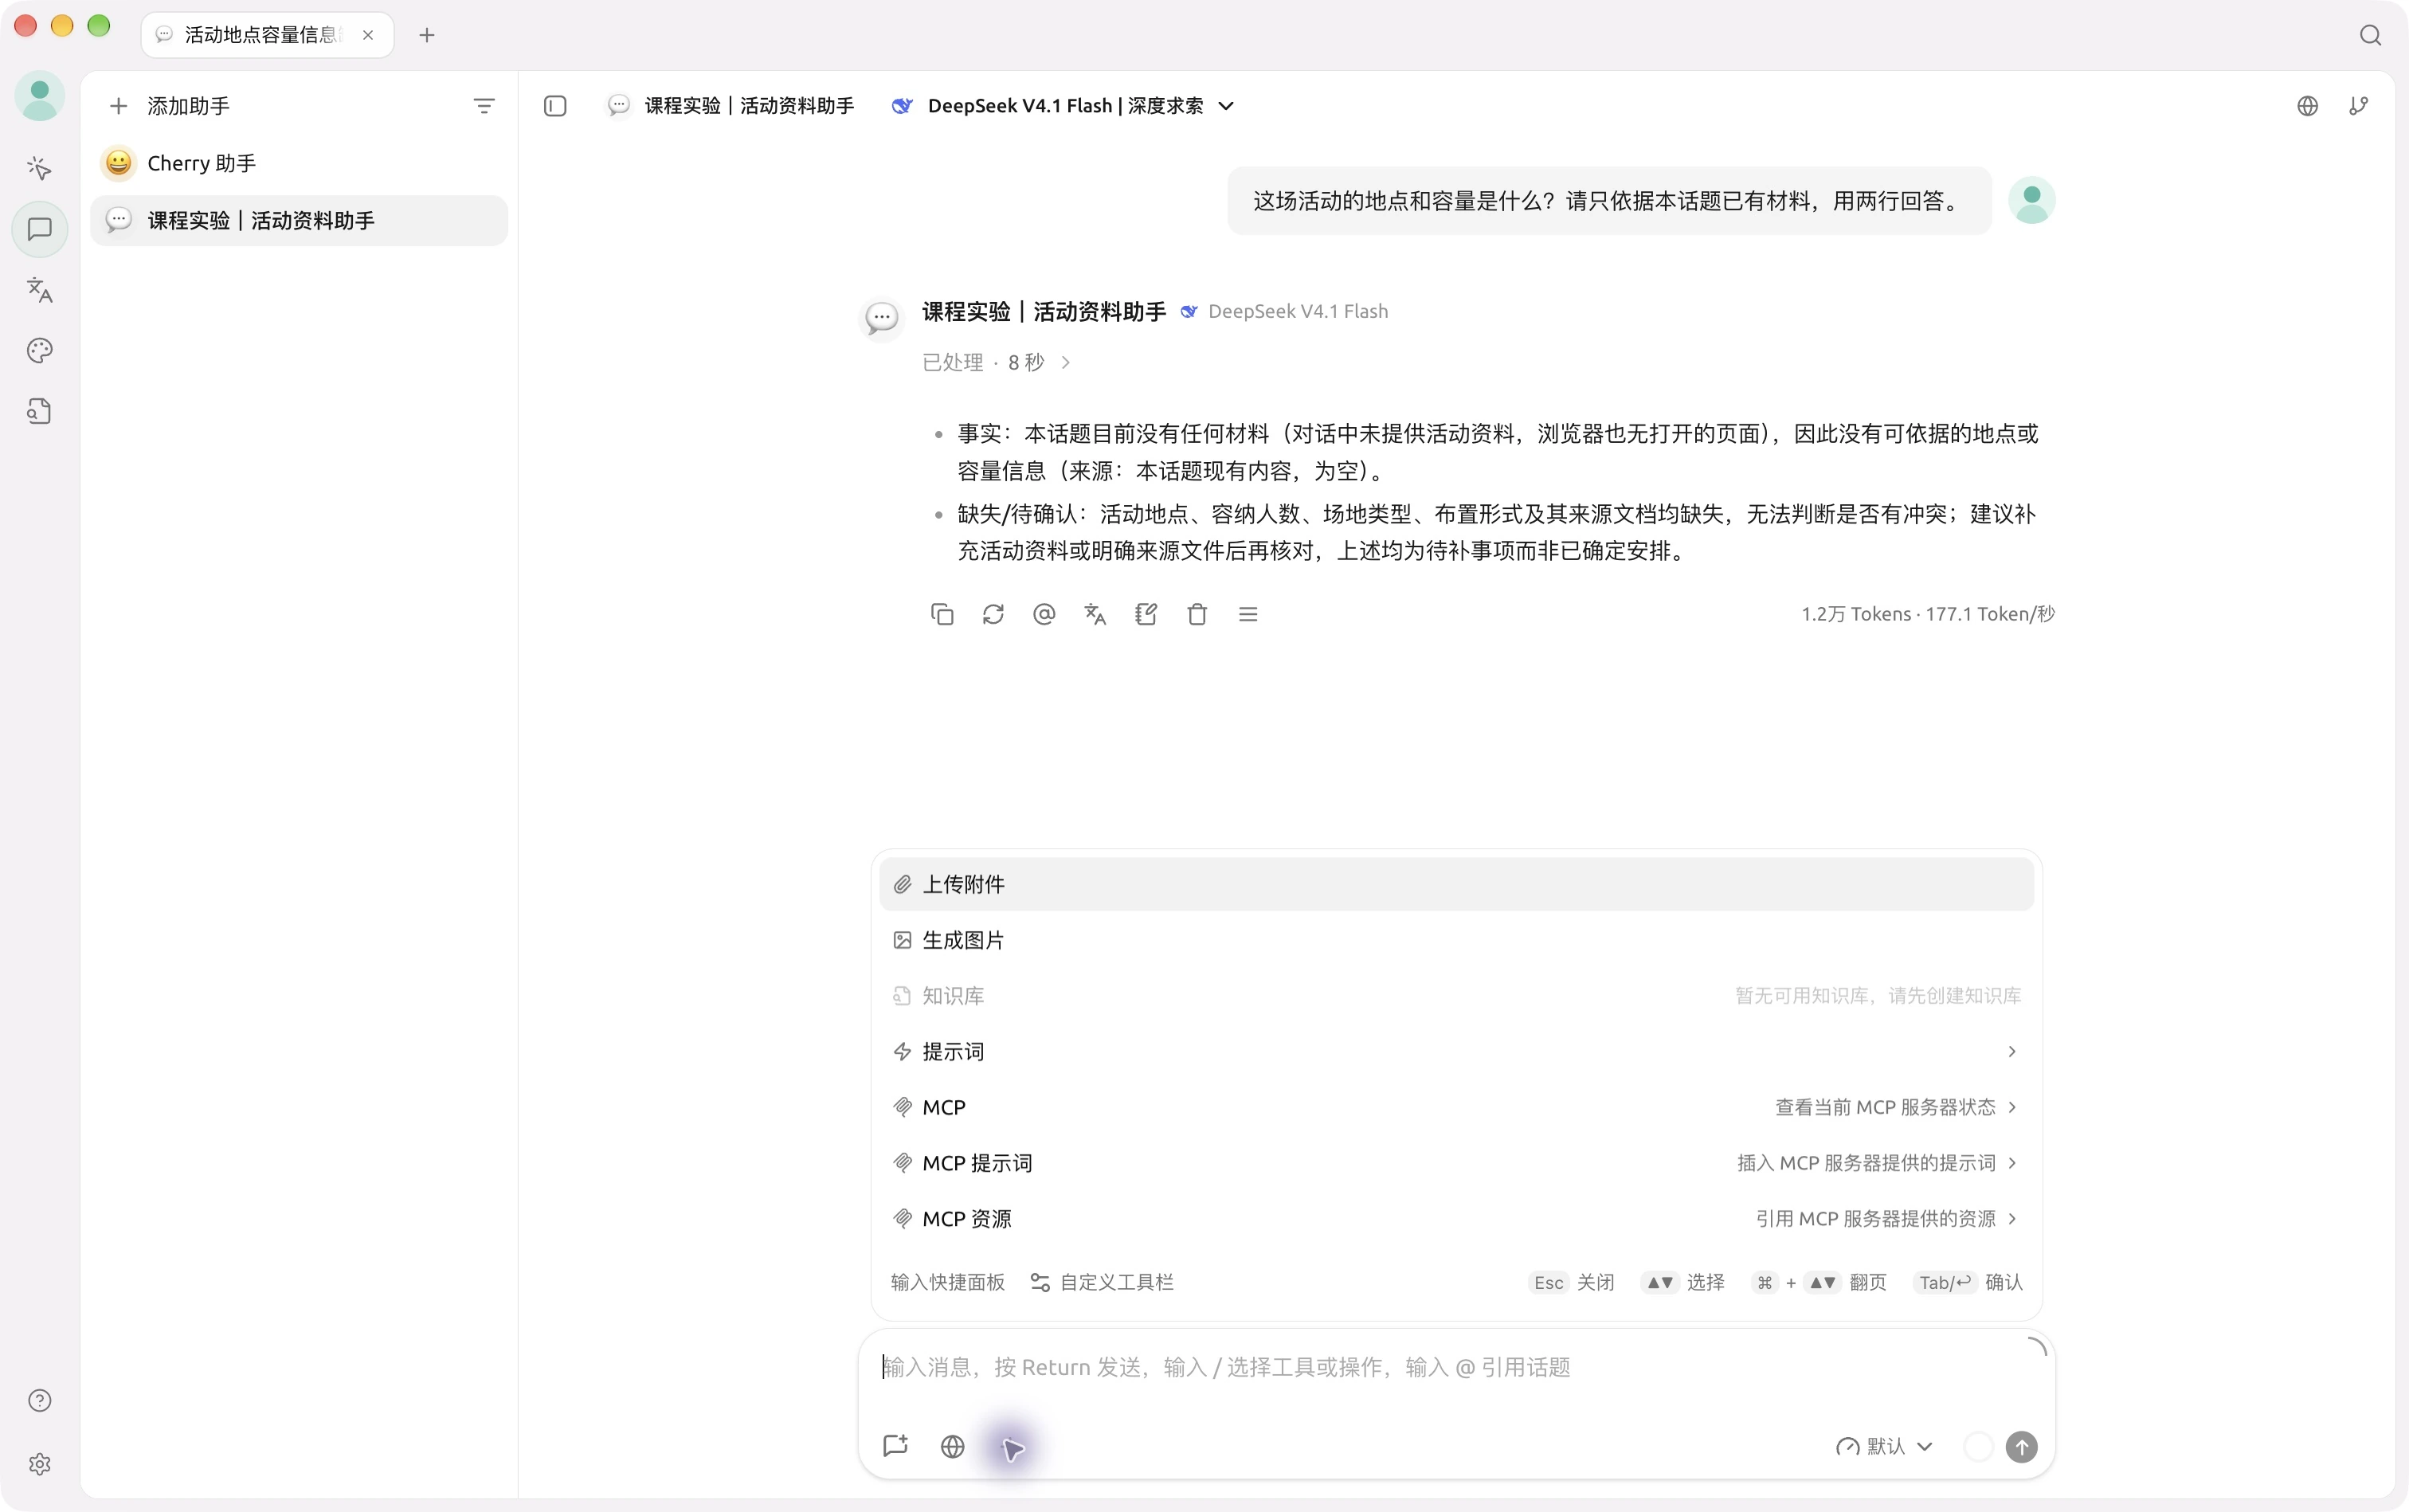
文本文件比较直接。PDF、Office 文件还可能包含段落、表格、页眉页脚和复杂排版,应用通常需要处理它们,再将适用内容送给模型。
解析出的文字可能出现阅读顺序错误、重复页眉或表格关系丢失。此时换一个更强的聊天模型,不一定能恢复已经被丢掉的条件。
不要只检查“导入成功”。先找一个答案明确的小问题,核对日期、数字、表头对应关系和来源范围。文档解析与 OCR
8.2 扫描件与可复制文字的 PDF
练习包的 activity-materials-text.pdf 可以提取文字,activity-materials-scan.pdf 将相同内容保存为页面图像。两者看起来相似,但内部结构不同。
扫描件可能需要 OCR,也可能经过视觉模型等处理路径。具体路线取决于应用和配置,不应仅凭回答正确就宣称它“必然用了 OCR”。
OCR 的错误常出现在数字、日期、符号和低清晰度内容。关键字段应与原件核对。若能看到处理后的正文,先检查正文,再检查回答。
实测:相同问题,文字版有结果,扫描版读不到正文
本机 Cherry Studio 2.1.6、课程助手与界面标示的 DeepSeek V4.1 Flash,在两个独立话题中分别上传相同内容的两种 PDF,并问同一问题:提取时间、地点、容量、状态筛选、去重键,以及 R05 的原文。
文字版回答中的六项与原件对应:10:00—12:00、301 室、30 人、只计已确认、按 participant_id 去重,以及活动开始前可取消的 R05。回答的其他判断还需逐条审阅;模型说“全文已读”,不能代替字段核对。
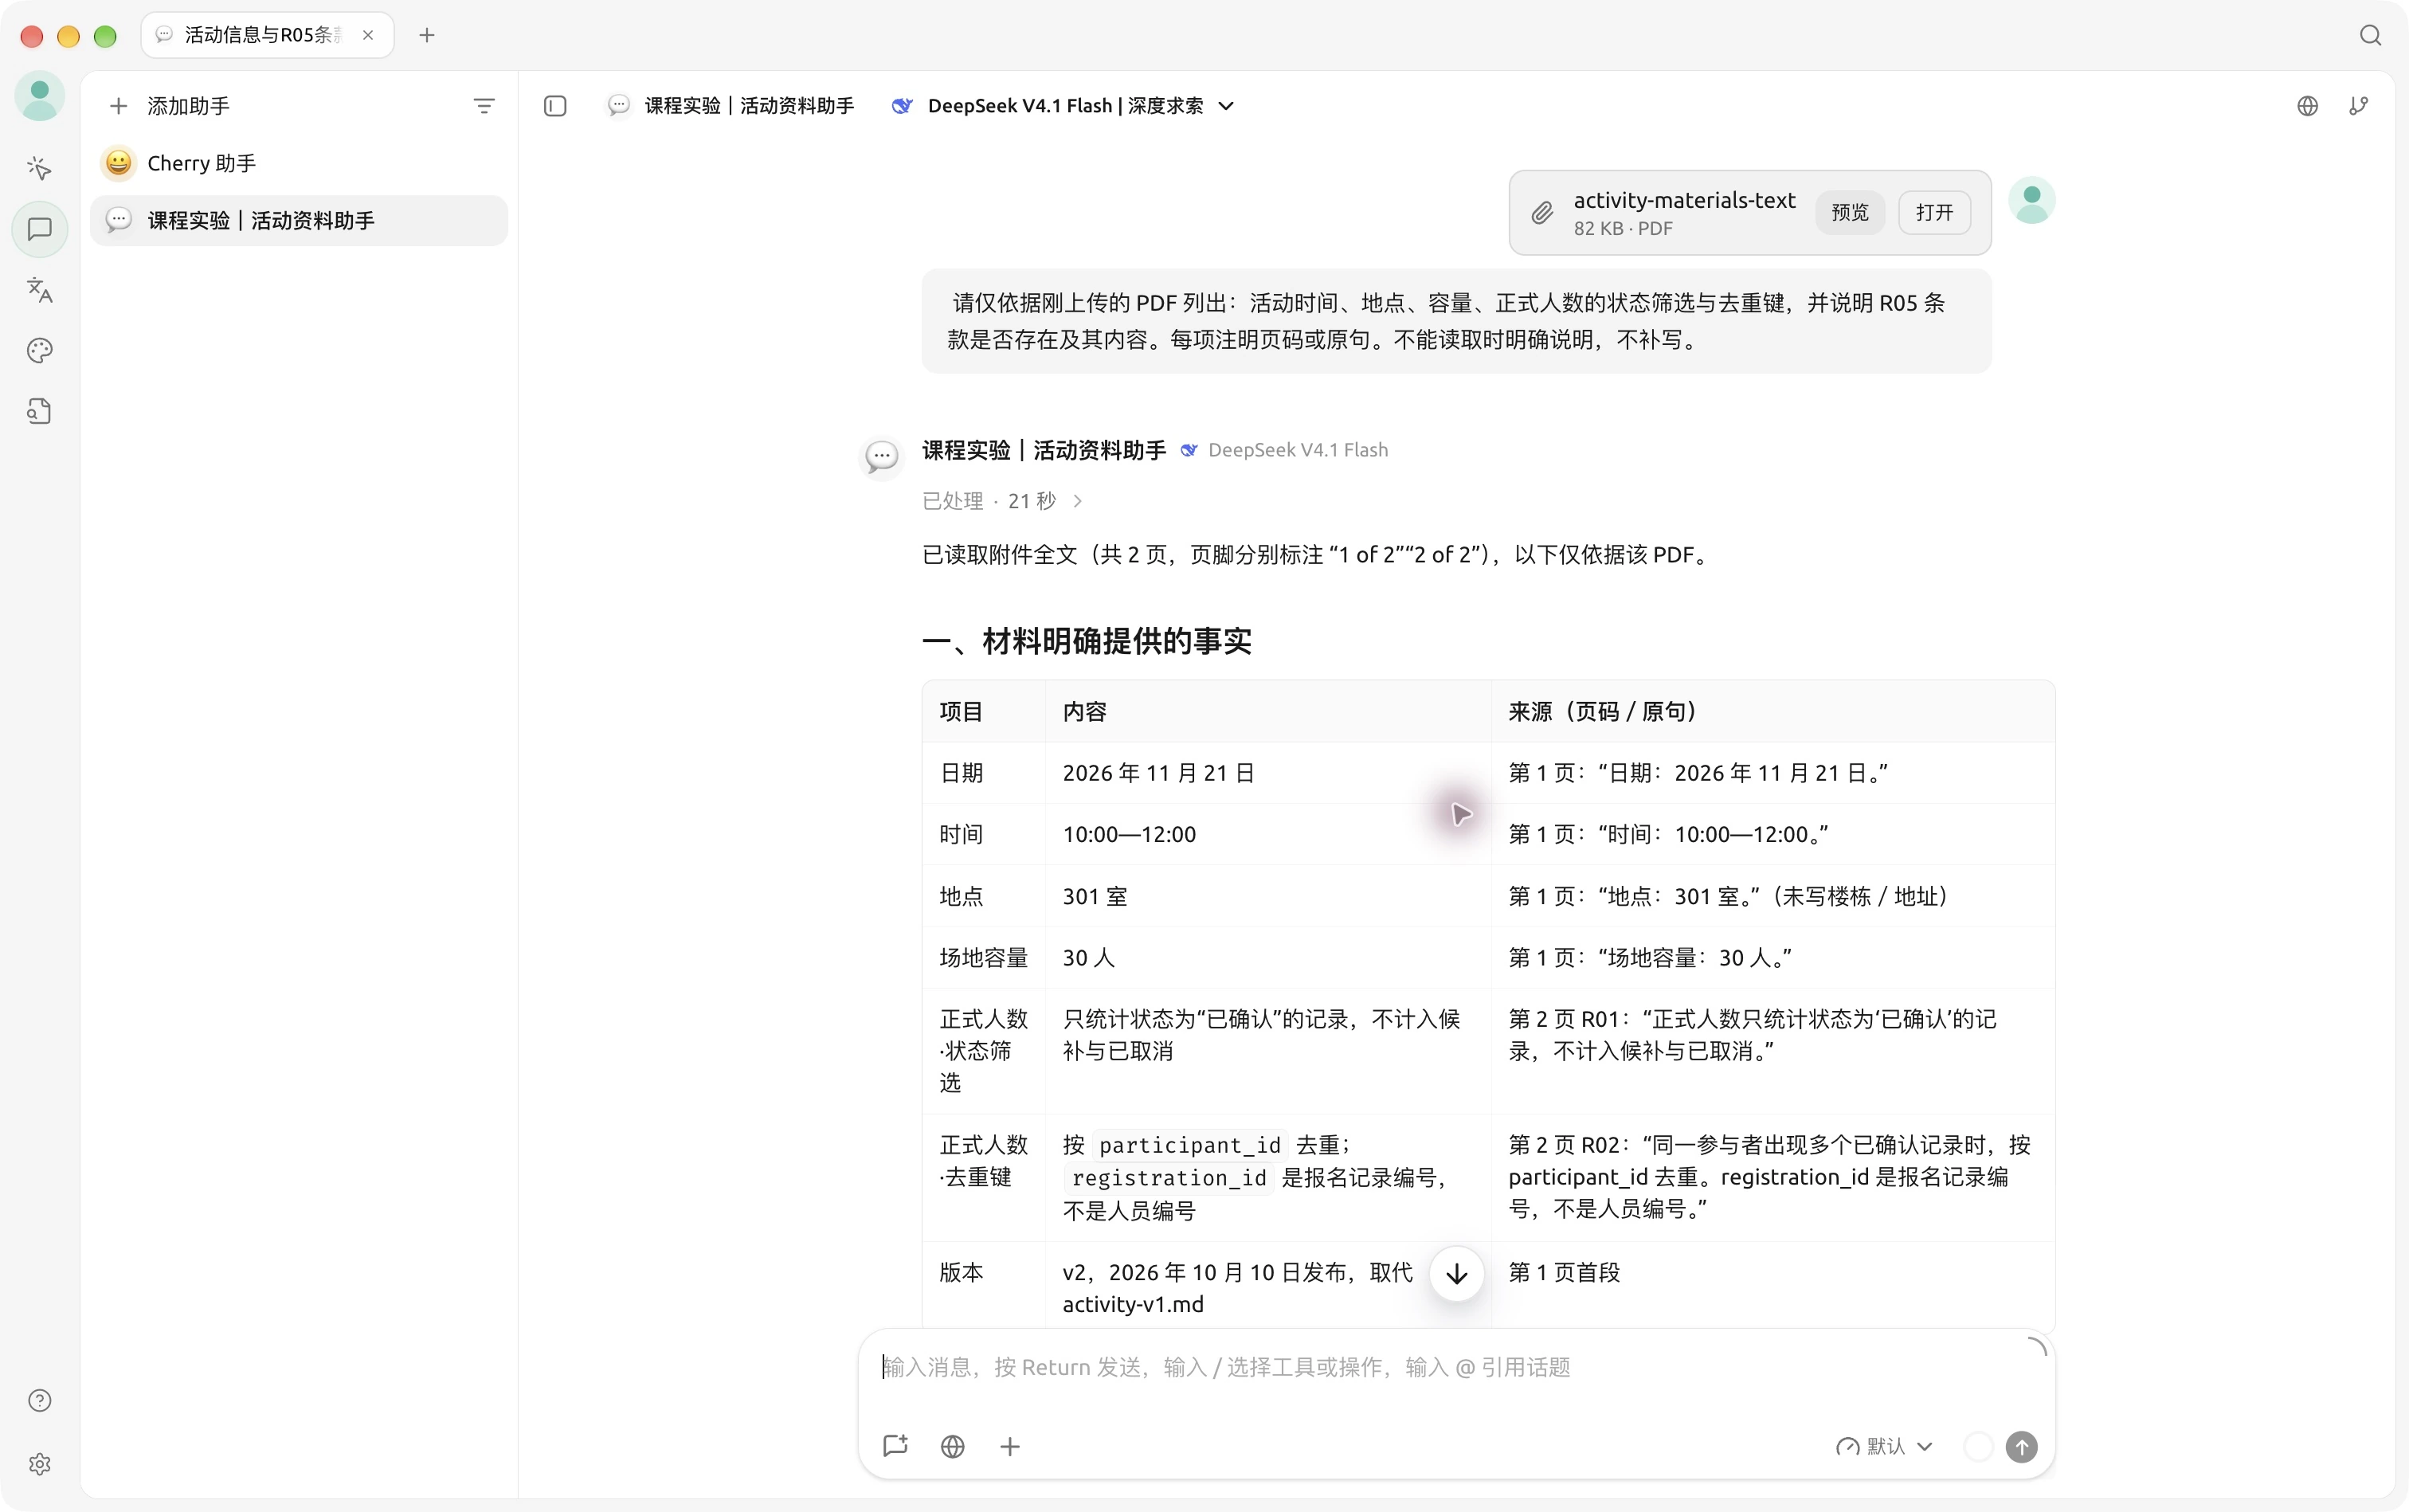
扫描版在当前配置下回答“正文无法读取”,没有沿用另一话题的活动数字。这里“不能确认 R05”表示没读到内容,不能解释成原件没有条款。
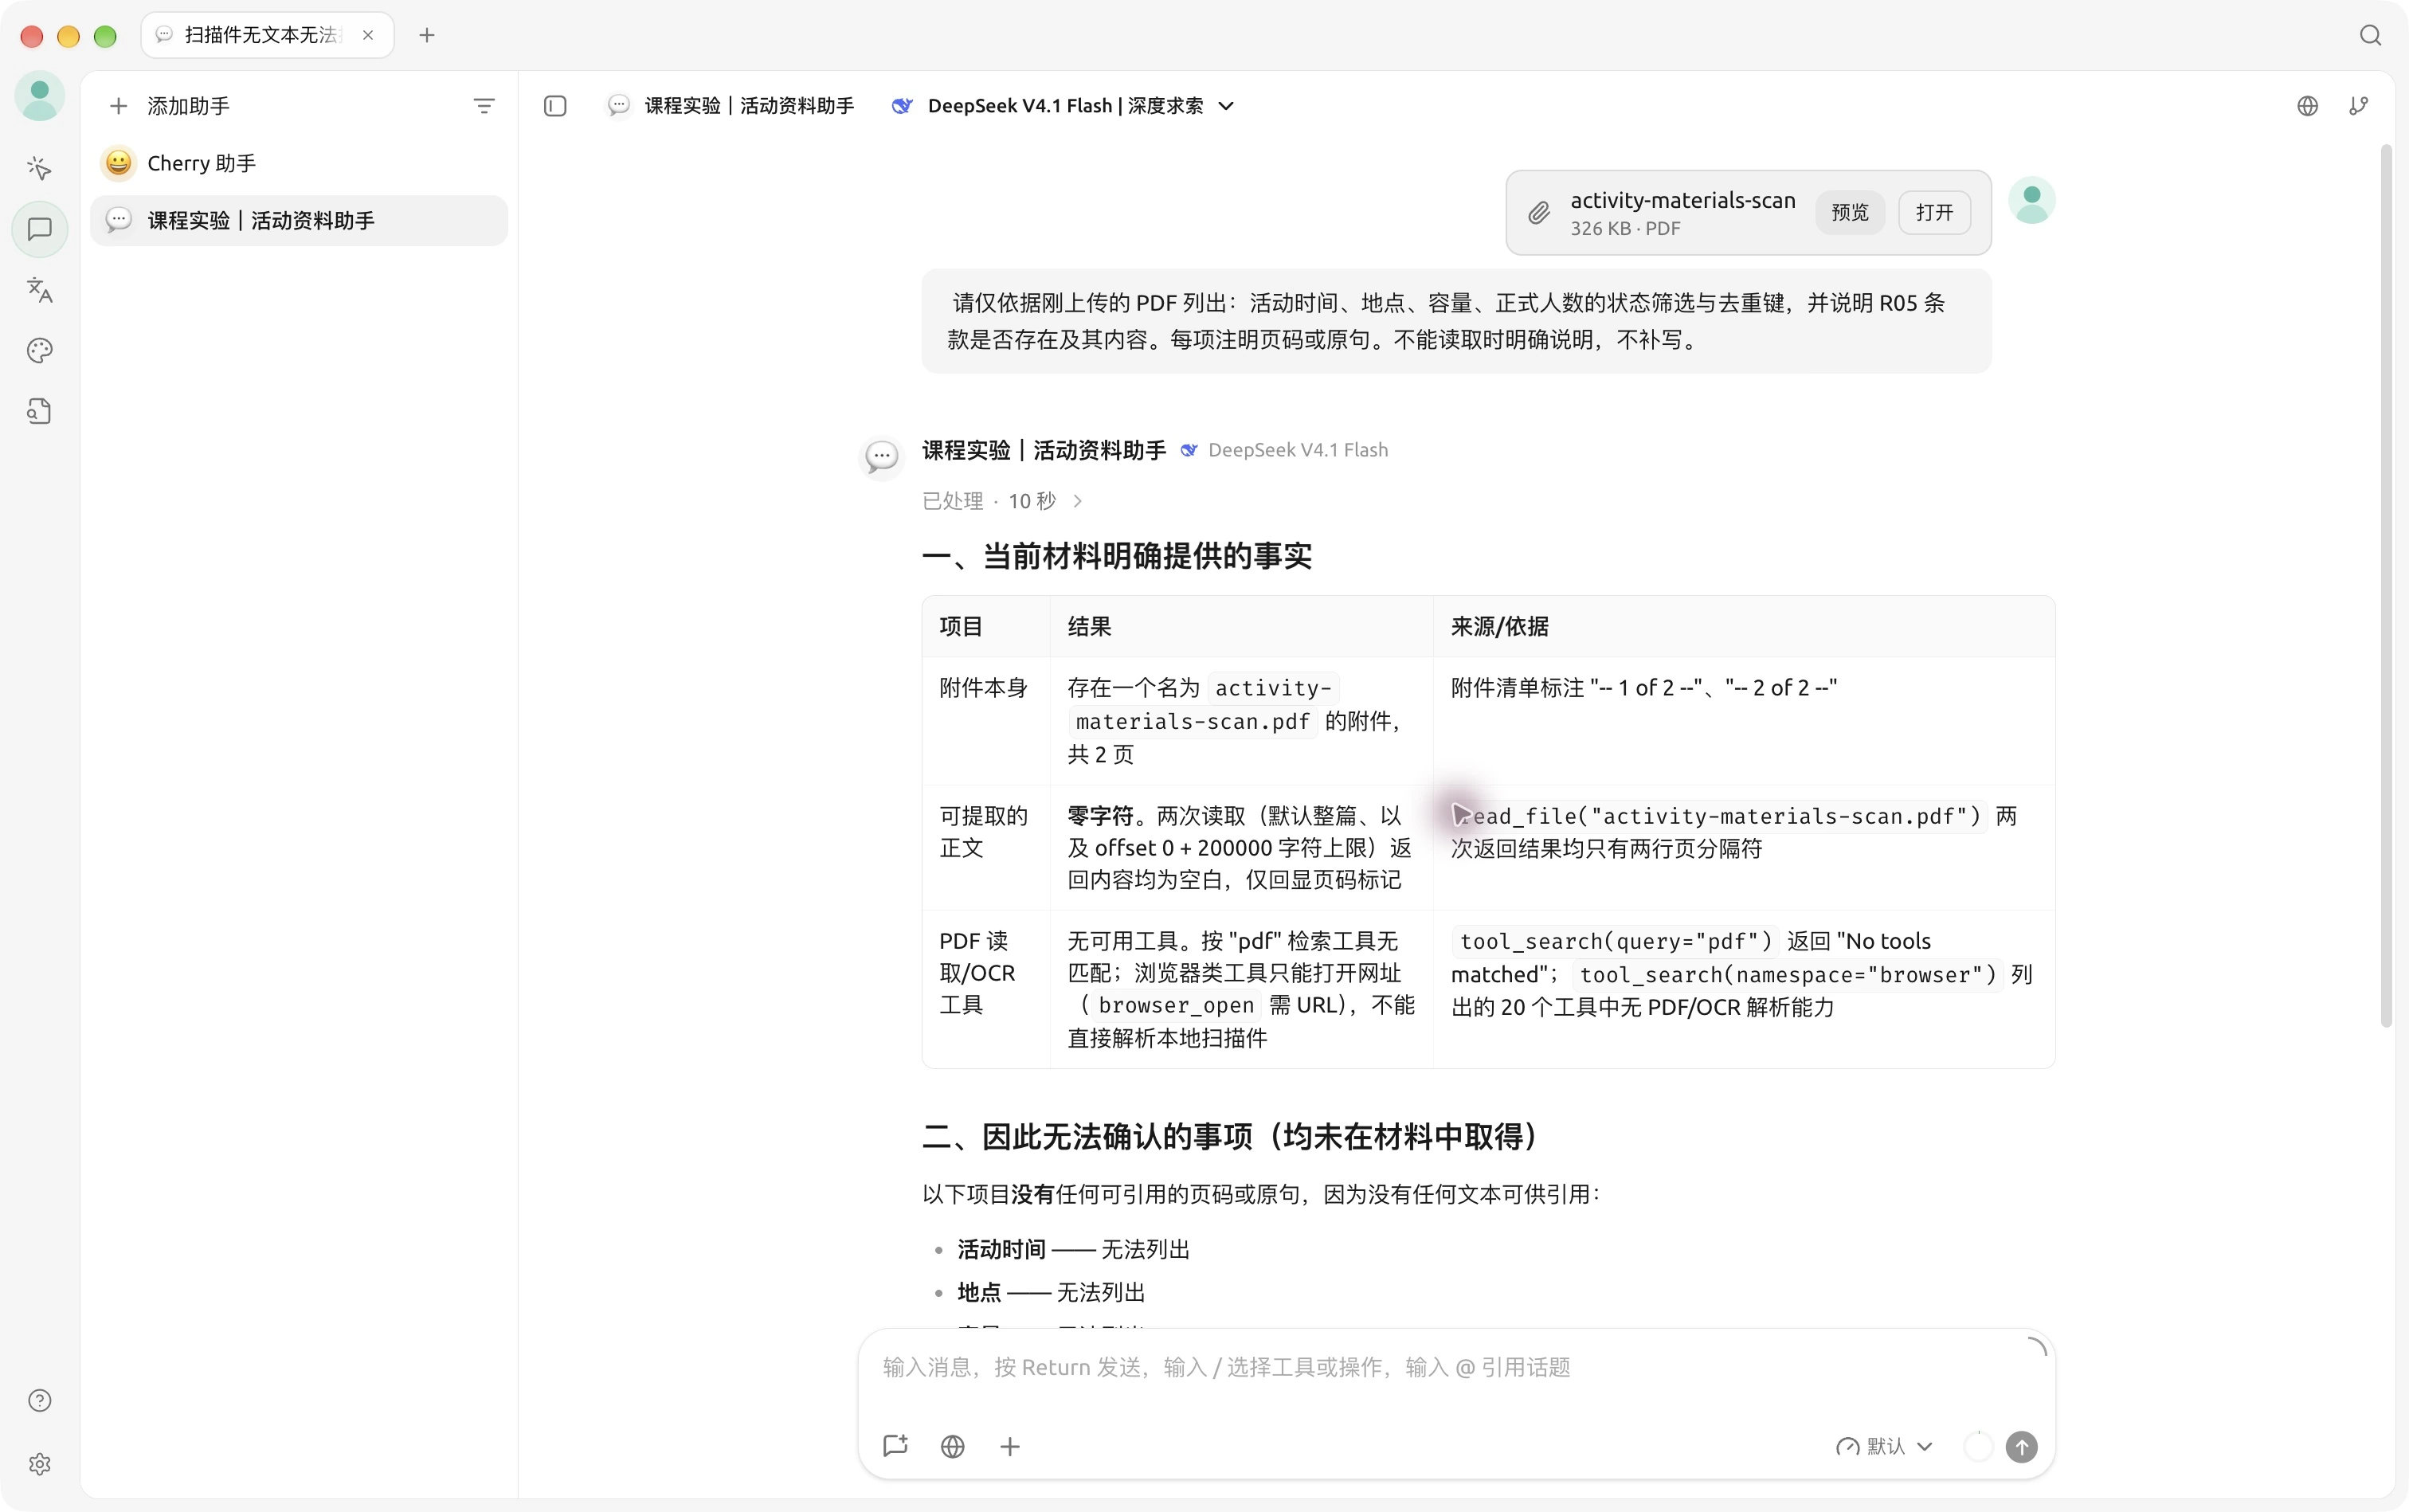
这组结果只说明本次配置与材料的表现。扫描版回答正文还自述了 read_file、tool_search 等动作,但该对话没有独立可见的工具调用卡片,不能仅凭这些文字认定动作真实发生。后面的“工作”实验会直接展开工具记录。
8.3 认字与理解关系分别检查
海报中的日期和地点是文字信息。统计图还需要检查坐标、单位和数量关系。视觉模型认出了“10”,不代表它知道这是报名行,而不是去重后的人员数。
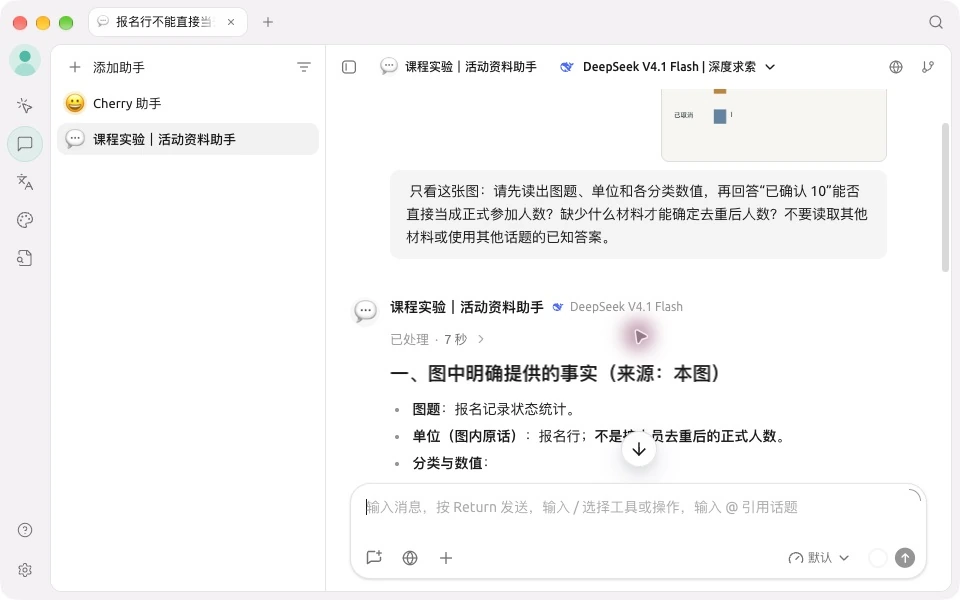
练习图明确标注单位为报名行。结合报名规则后,才可以计算正式人数。一个答案若忽略了单位,即使语气很确定,也应回到原图和原数据检查。
实验 E15 用不同形式提供同一信息
准备
下载素材包,使用 materials/formats 下两种 PDF、images 下海报与报名图。先确认使用的文件处理、OCR 或视觉能力可用。
formats 中另有字段表与双栏 HTML 样本,供检查结构和阅读顺序。它们是额外的版面练习,不与两种相同内容的 PDF 混成一个控制变量对照。
操作步骤
- 在独立话题中添加文字版 PDF,要求提取地点、容量和去重规则;保留文件名与实际回答。
- 新话题中添加扫描版,使用完全相同的问题。若处理失败,记录实际错误,不补写成功结果。
- 对照可见的解析正文和原页;中间结果不可见时,只记录行为与字段核对,不推断全部处理机制。
- 分别添加清晰与低清晰度海报,要求列出可确认与不可确认字段。
- 添加报名图,先提取图题和单位,再说明“10”代表什么。
- 最后加入报名规则与 CSV,核对为什么正式人数是 9。
请阅读这份材料,列出:
1. 明确可确认的日期、时间、地点和容量。
2. 涉及人数的单位或统计口径。
3. 看不清、没有提供或存在冲突的事项。
不要凭常识补写。若不能处理附件,请说明实际限制。
完成标准
提交跨格式对照表,分别记录解析、识别、关系理解和最终回答。不要把未测试的格式写成“支持所有文件”。
参考解释
两种 PDF 的当前地点与容量应是 301 室和 30 人,规则要求按 participant_id 去重。图中的已确认 10 是报名行,正式人员数需要结合规则计算。若只看图而缺少原表,不能凭空知道重复了谁。
实测:清晰图与低清图都要核对,而不是预设谁会失败
使用同一助手与模型、相同问题,在两个独立话题分别上传清晰与低清海报。本轮两者都提取出正确的活动名、日期、10:00—12:00、301 室和容量 30。低清版本虽然模糊,关键字段仍被识别出来;不能为了讲解而把它写成失败。
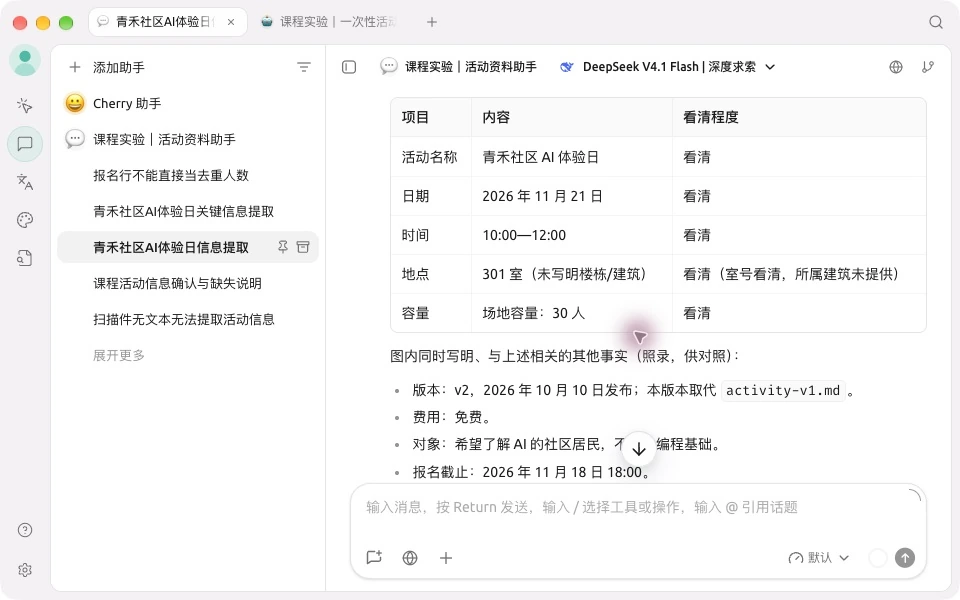
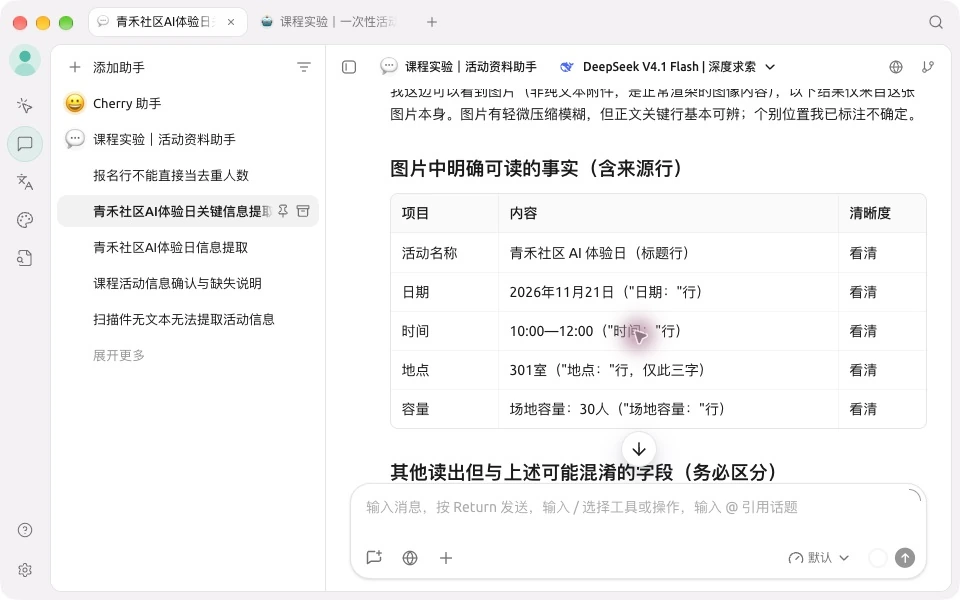
清晰图回答的补充分析把“容量上限”和“正式人数统计”列为潜在冲突,这个判断并不成立:两者原本就是不同指标。它再次说明认字正确之后,还要检查概念与推理;不能直接照搬模型的全部解释。
统计图单独放进一个新话题后,助手读出“已确认 10、候补 1、已取消 1”,并识别单位是报名行。它没有仅凭图片给出去重人数,而是要求原始明细和统计规则。这里可以用它来检验“看见数字”与“知道数字代表什么”的区别。
8.4 网址不是正文
提供一个网址,只告诉程序去哪里找。它是否具有网页读取能力、能否获取、是否遇到登录或页面限制,需要另外确认。
搜索列表的摘要也不等于原文。一个具体结论应尽量回到对应正文,核对时间、版本和适用范围。
实验 E16 判断回答有没有实际网页依据
准备
选择课程已引用的Cherry Studio API 基础知识页面。不要使用个人邮箱、后台订单或其他私人页面作练习。
操作步骤
- 先只提供网址,要求助手说明可依据哪些实际内容回答。
- 在当前环境已配置网页读取或搜索能力时,获取正文,查看实际来源和读取结果。
- 另开话题,将你独立读取的一小段正文直接粘贴进去,问同样的问题。
- 回到原页检查一个具体结论,例如助手与 Agent 的用途区分。
- 记录来源链接、获取日期和处理范围;页面失败或未获取正文时保留限制。
请依据这个官方页面解释助手与 Agent 的区别。
先说明你实际取得了哪些内容,再给出结论与来源。
若只知道网址、没有读取正文,请明确说明,不假装已经查看。
完成标准
能区分网址出现、正文取得、引用存在和结论被支持。若实际输出不能证明读取范围,就保留未知,不仅凭模型自述认定全文已读。
参考解释
直接粘贴的正文可以明确确认进入了当前输入;网页读取的范围依实际返回检查。来源链接有助于追踪,但仍需回到原页核对是否支持整条结论。
8.5 理解图片与生成图片是不同能力
这一层重点是让模型利用输入材料。生成图片需要相应输出能力或工具,不能由“这个模型会看图”直接推出。第 10 章之后会在 Agent 的工具分工中继续观察。
自检题
01附件上传成功,是否证明全文被正确读取?
不能。后面可能还有解析、OCR、选择或截取。需要检查正文与关键字段,必要时核对具体来源位置,而不是只看文件名或上传回执。
02OCR 和视觉理解有什么不同?
OCR 重点把图中文字转成可处理文字;视觉理解还可能分析图中对象、布局和关系。认出文字不代表理解表格关系,也不能凭回答断言软件采用了哪条内部路径。
03给出网址,是否等于提供了网页全文?
不等于。网址是地址,正文还需要通过可用能力获取。搜索摘要、获取正文和实际将内容用于回答也应分别核对。
04报名统计图显示已确认 10,为什么正式人数可能是 9?
素材图的单位是报名行。报名规则要求按 participant_id 去重,因此 10 条已确认记录对应 9 位正式参与者。必须同时检查图的单位、原数据和统计口径。
下一章理解知识库与有依据的回答:当资料较多时,怎样先检索再使用。