
09 知识库与有依据的回答
只有一页活动说明时,直接提供全文很容易。资料增长到几十份以后,每次把全部内容放进输入不一定合适。知识库提供了一条路线:先根据问题找到相关资料,再把适用内容用于回答。
这一章要把这条路线拆开。模型回答错了,可能是资料根本没有答案,也可能是解析、分块、检索或最后的解释出了问题。
9.1 RAG 连接检索与生成
RAG 通常指检索增强生成。它把资料查找和内容生成连接起来:问题进入检索系统,相关片段进入模型上下文,模型根据当前输入组织回答。
这条链路没有自动保证正确。导入回执不证明正文完整,召回了一个片段不证明它适用,模型给出引用也不证明它支持全部结论。
9.2 入库时发生什么
资料先需要被正确解析,再切成检索单元。分块太小可能把条件与结论分开,太大可能把多个主题混在一起。重叠帮助保留边界附近内容,但也会增加重复。
来源、日期、版本和适用对象也很重要。社区初版的容量 40,不能因为含有“活动容量”这个词就被当成当前答案。
9.3 关键词检索与语义检索
关键词检索比较问法和原文词语等信息,适合编号、名称或明确词汇。嵌入模型把文本表示为向量,用于相似度查找,可能帮助处理改写或口语问法。
当前官方文档介绍了 BM25 关键词起点,以及加入嵌入后的混合检索。不要把这里的对照误写成“纯关键词”与“纯向量”,也不要把检索表示等同于模型对整套资料的完整理解。模型与检索设置
9.4 重排序 Top K 与阈值
初步召回后,可以按需要重排序。Top K 控制保留数量:太少可能漏掉条件,太多可能增加噪声与上下文负担。阈值是否可设、作用在哪一层,依具体实现确认。
检索分数不是结论正确率,不同阶段的分数也不能随意混用。调优要用固定问题集,每轮只改一项,记录改善、无变化或退化。
实测:先看召回,再看回答
本机建立“课程实验|活动知识库”,只导入 activity-current.md、registration-rules.md、venue-notes.md。三份文档显示就绪后,在“召回测试”输入“当前活动地点、容量和正式人数的去重规则是什么?”。
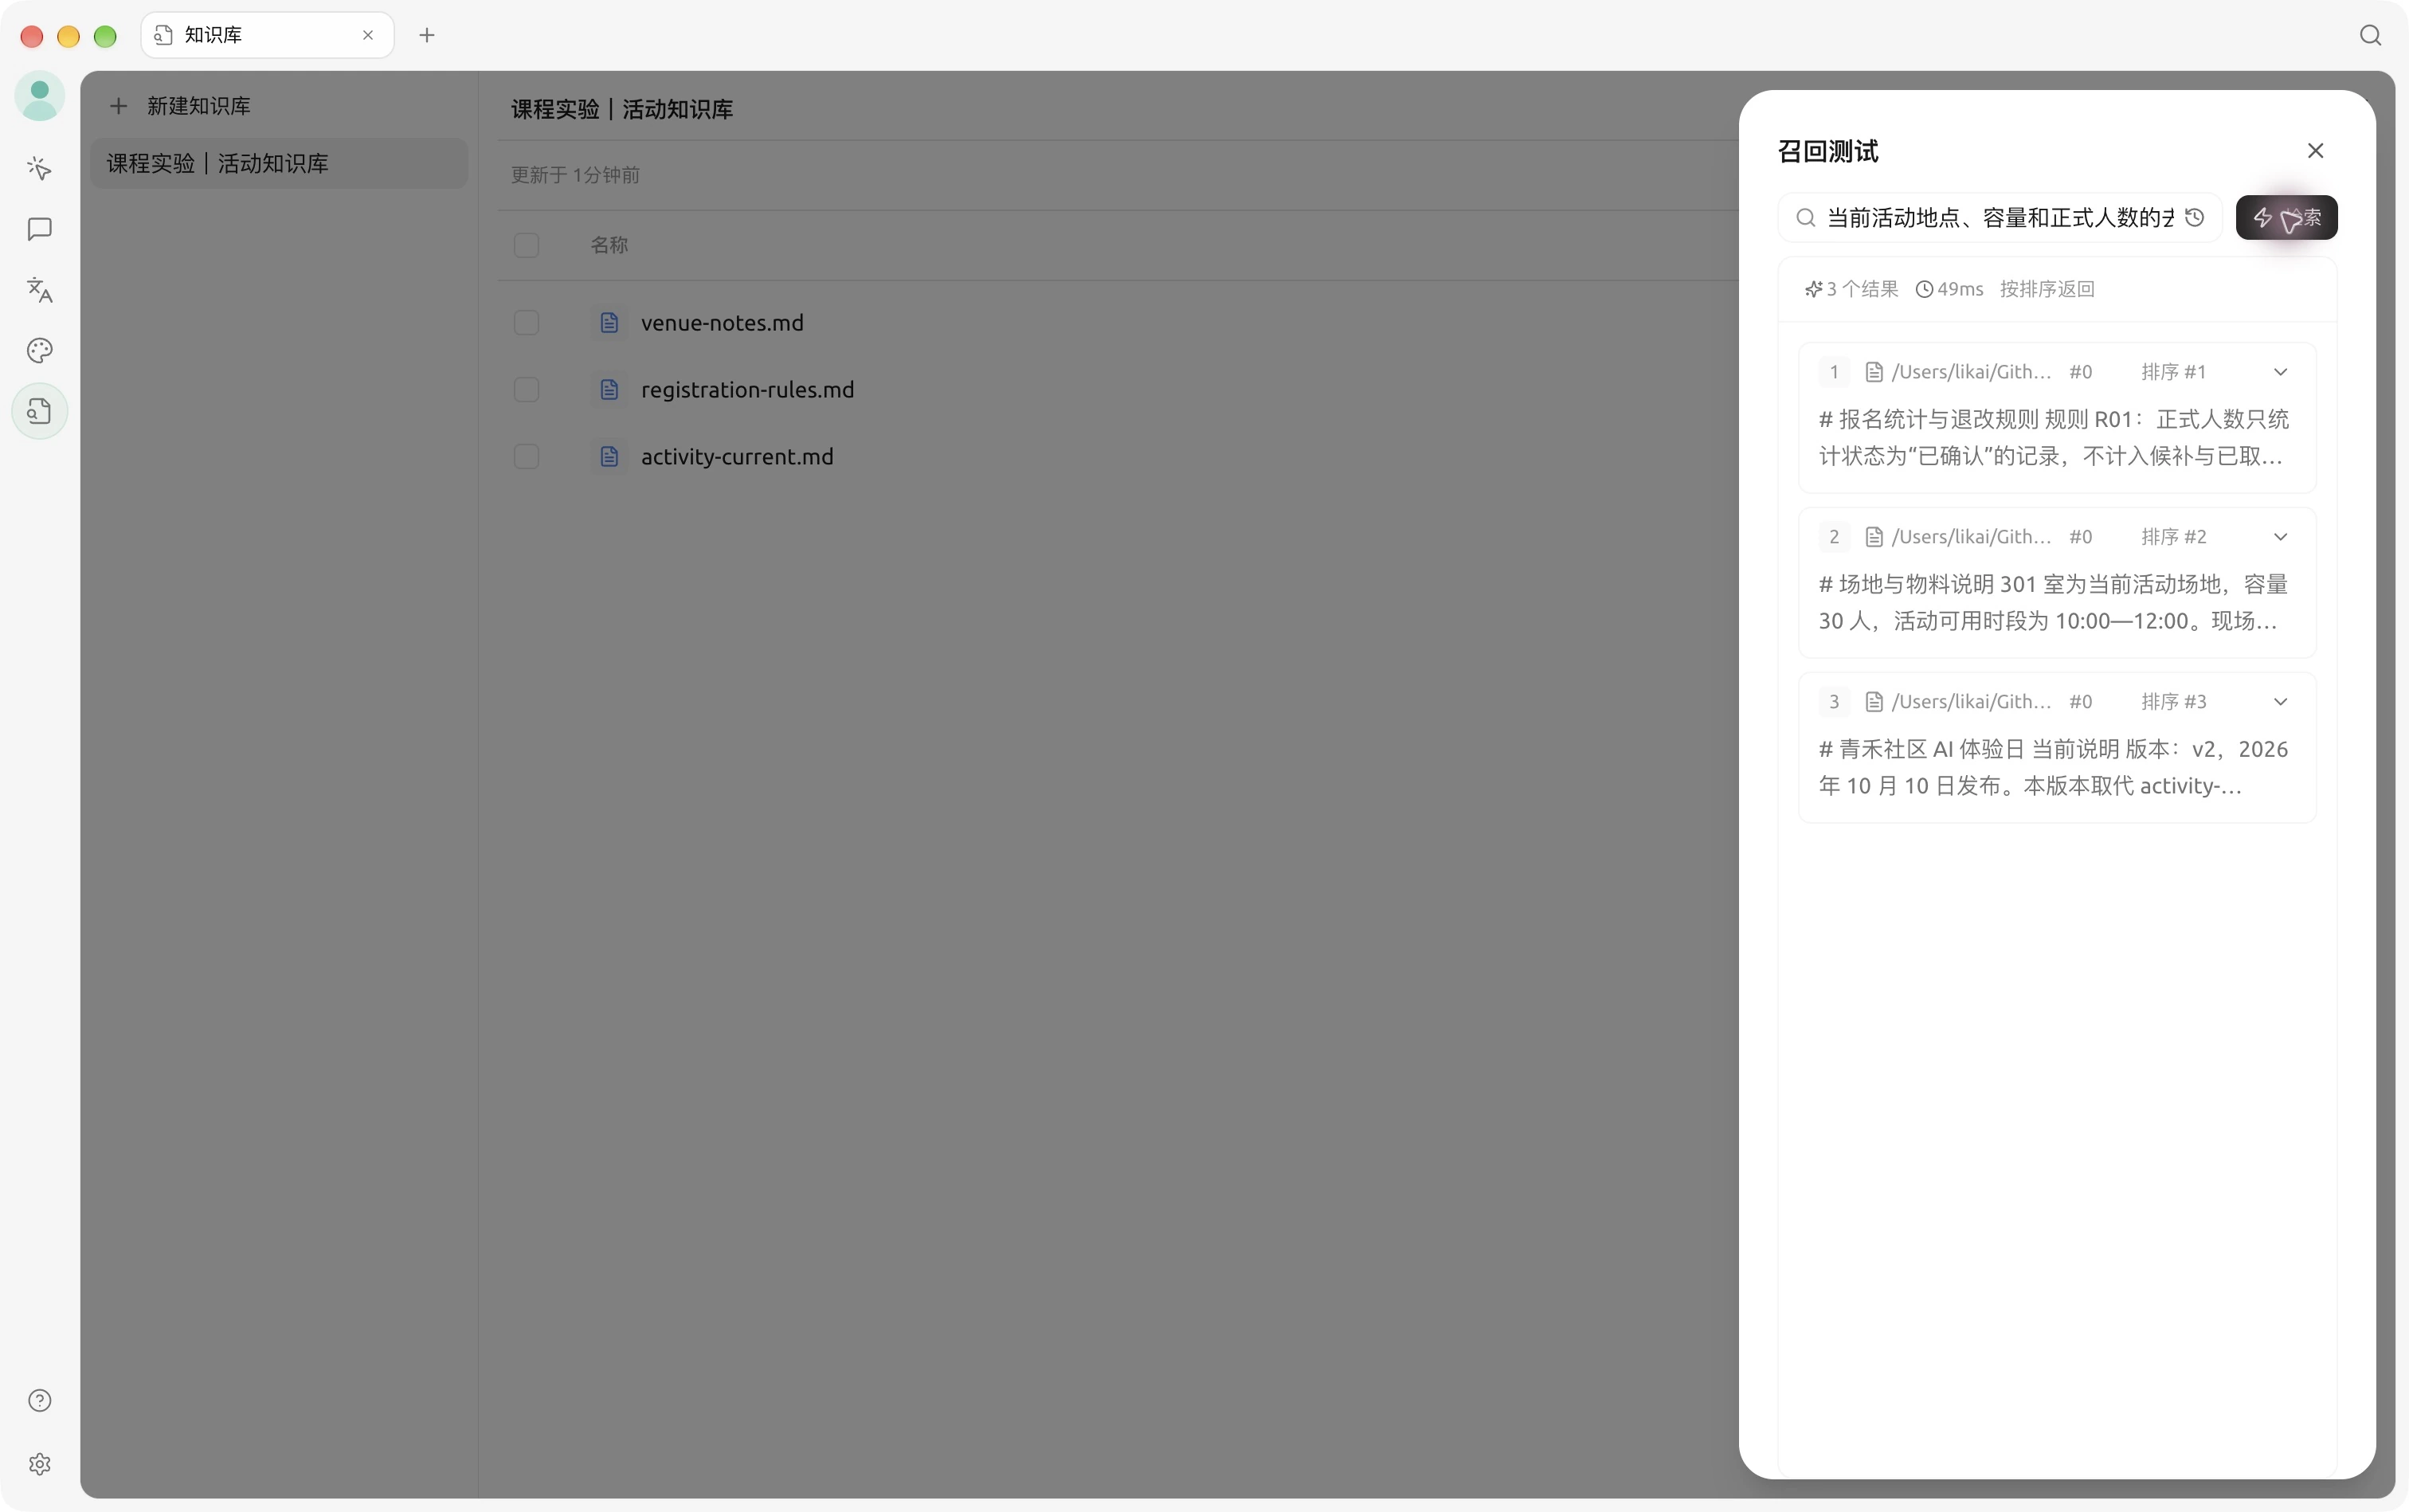
返回三项,依次是规则、场地说明、当前活动说明,片段内能核对 301 室、30 人与 participant_id。先确认这些必要条件进入候选,再问助手怎样使用它们。
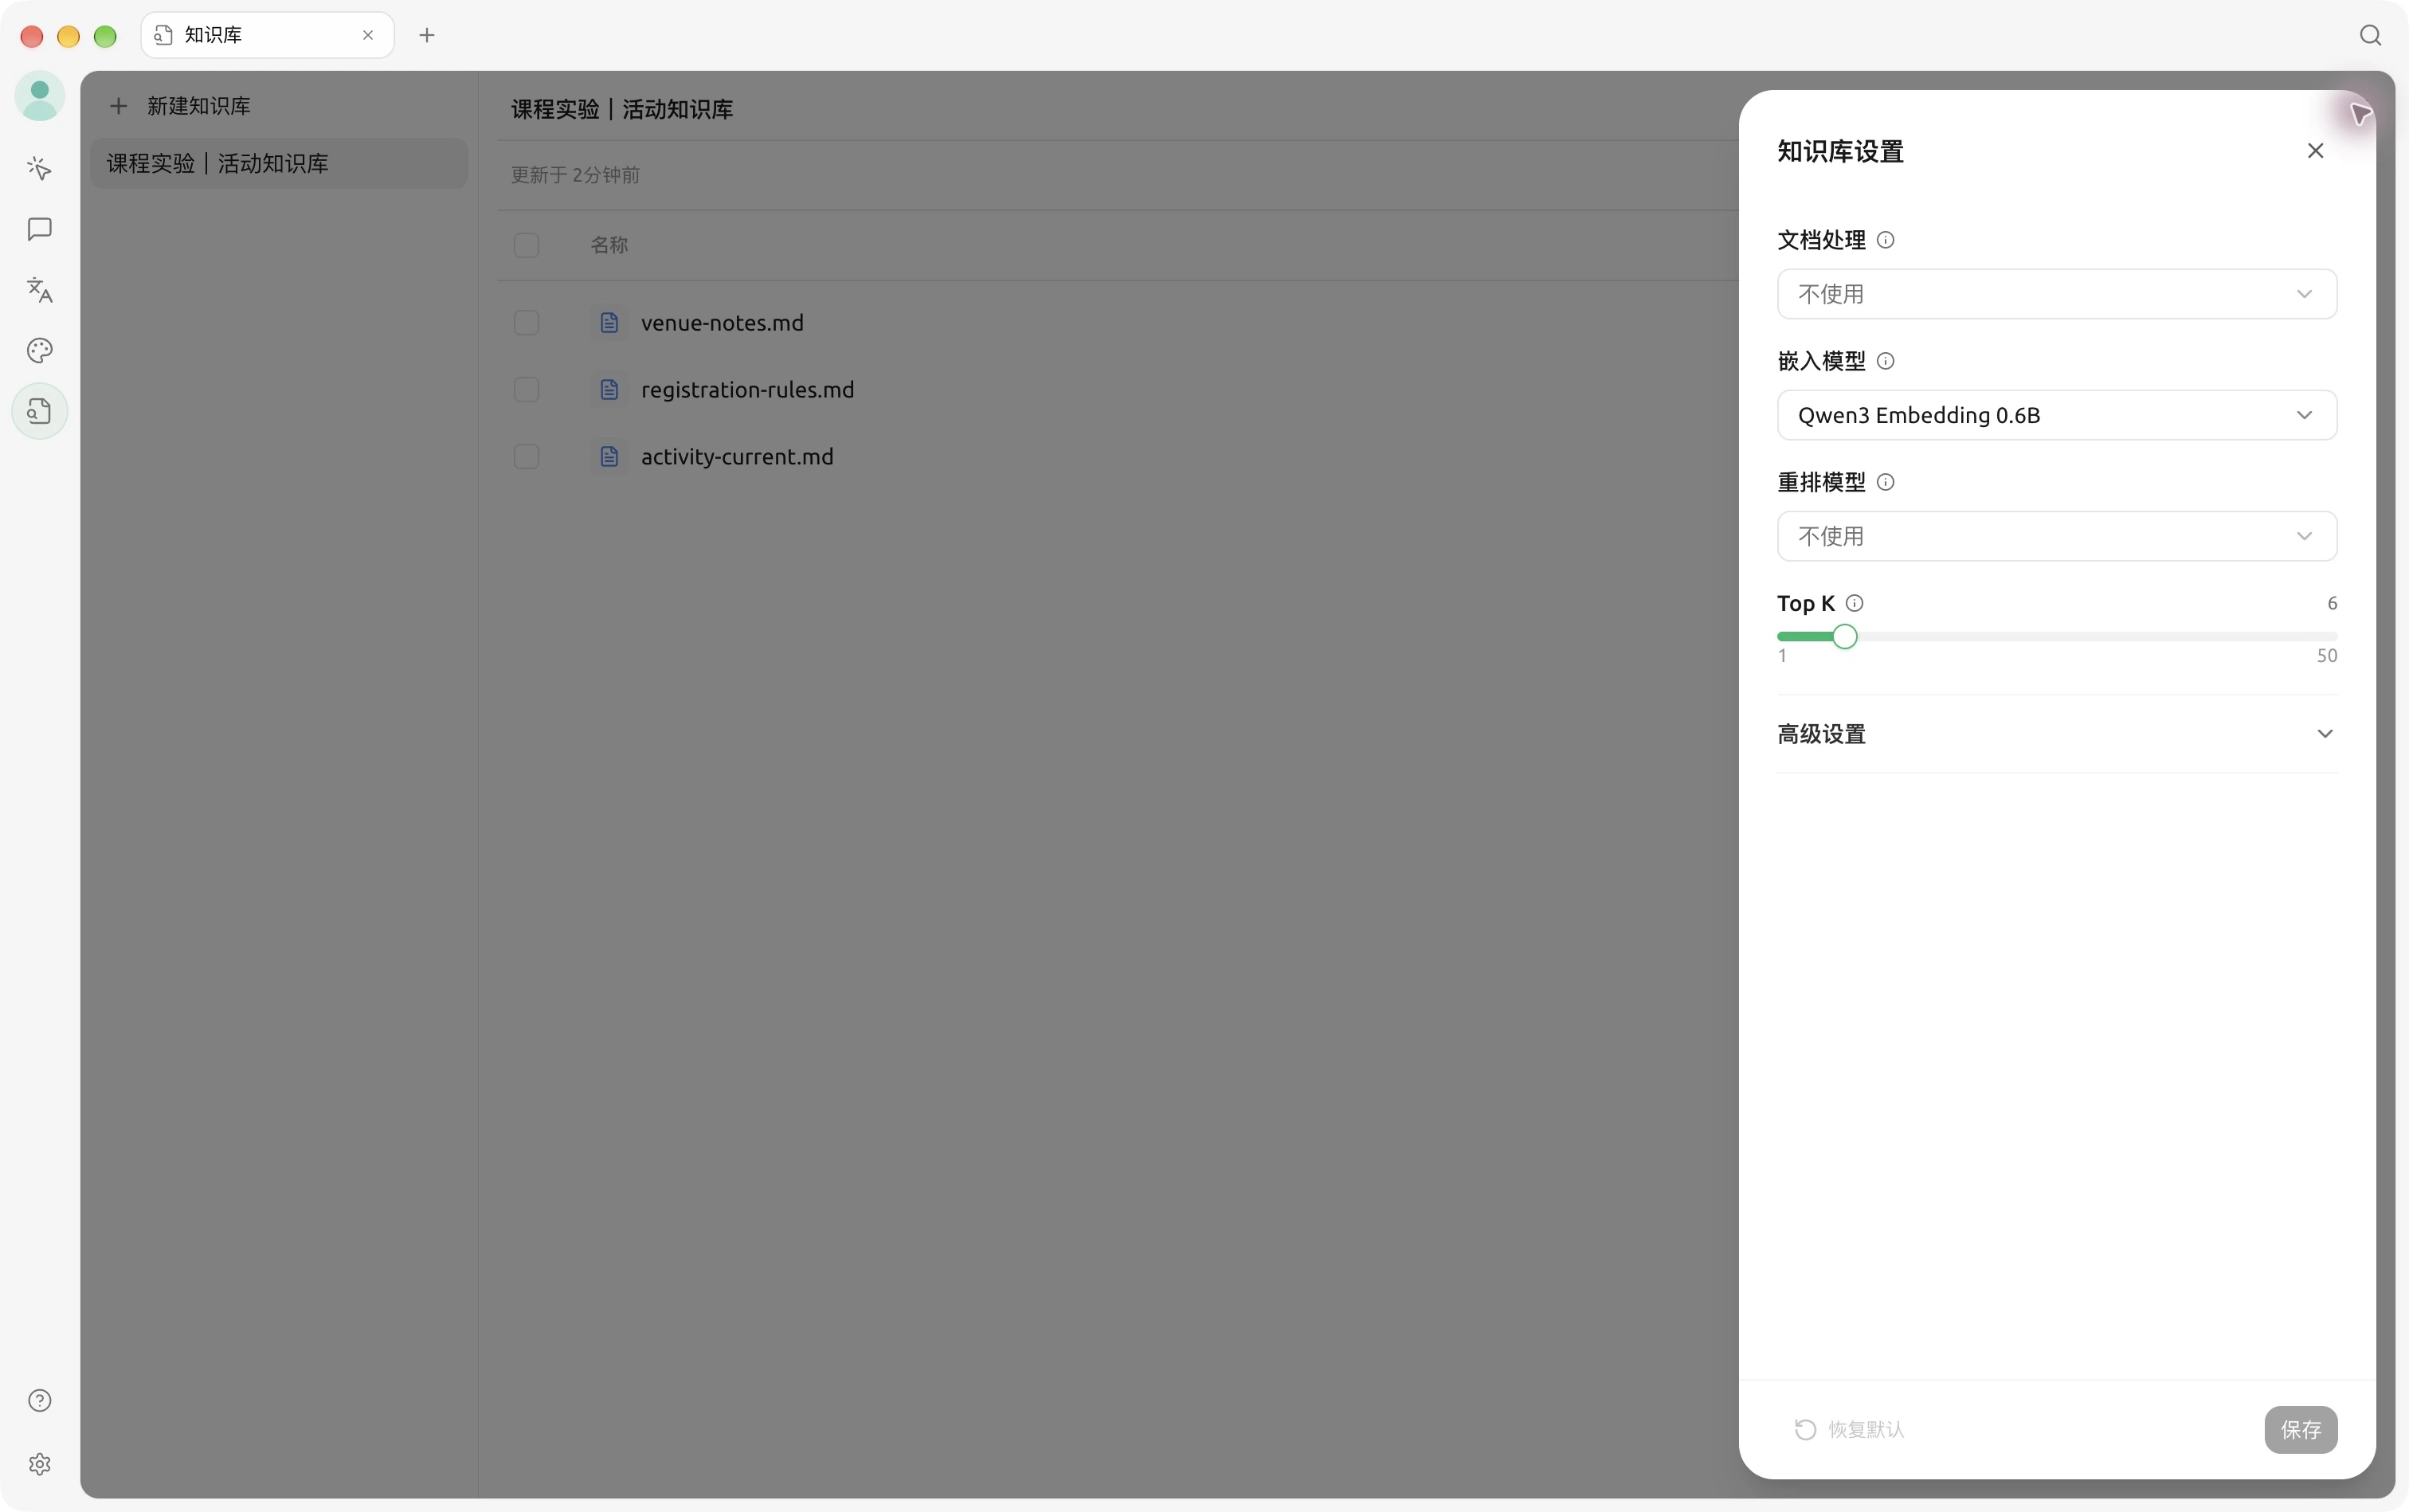
当前设置为 Qwen3 Embedding 0.6B、Top K 6、重排“不使用”;创建时通过产品提示下载了本地模型。此轮证明这些材料能被实际召回,不是关键词与向量检索的效果对比,也不能从三项结果推断所有问题都能正确回答。
在新话题的输入快捷面板中选择课程知识库后,助手回答 301 室、30 人、只计已确认并按 participant_id 去重,显示三个引用内容。交通费没有被补成具体金额。因为本库没有导入 CSV,它也没有凭空报出正式人数。
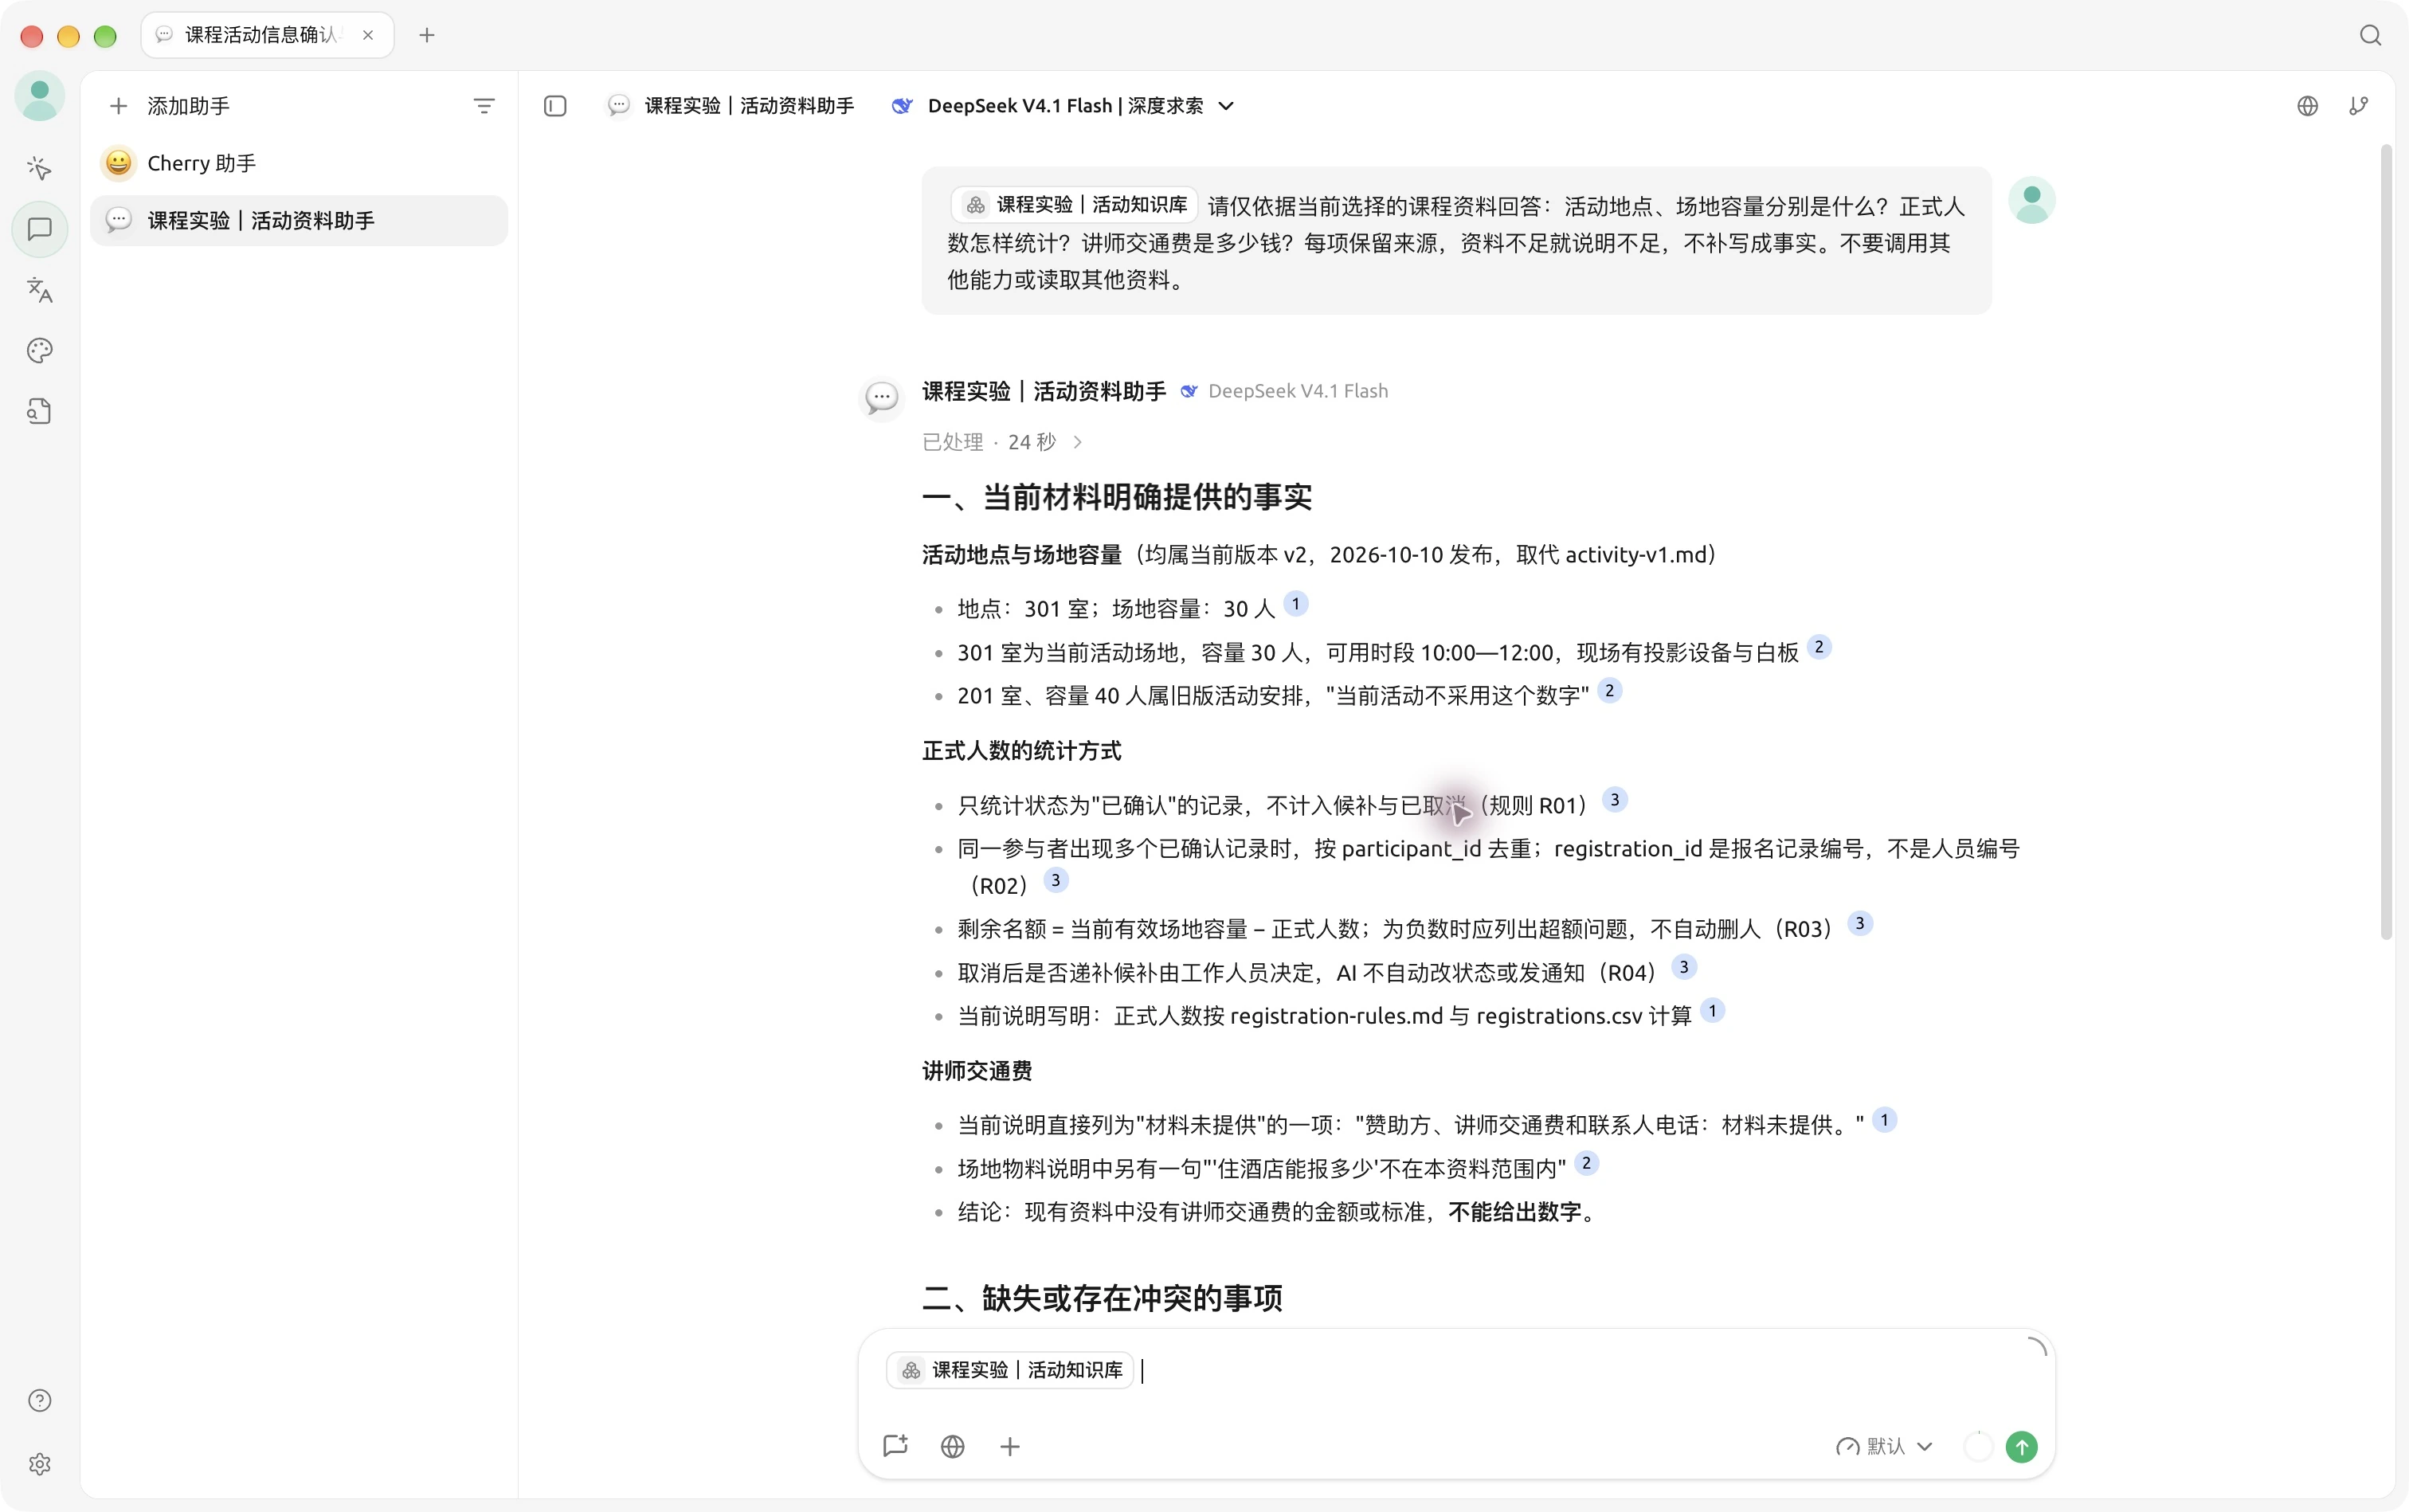
这次所问字段与原资料相符。引用编号的存在仍不能替代原文核对;检索面板中的实际片段为核验提供了另一条路径。
实验 E17 全文输入与知识库检索
准备
素材中的当前活动说明、报名规则和场地说明。先检查正文,用这三份小材料建立课程知识库,不导入私人库。
操作步骤
- 创建名称清楚的“课程实验|活动资料”知识库。若当前版本允许,先选择不使用嵌入模型,跑通关键词链路。
- 添加三份 Markdown,等待处理状态完成,检查正文与来源。
- 在一个新话题直接提供全文,问当前地点、容量、去重规则和交通费。
- 另开话题使用课程知识库,先在召回测试中看片段,再在对话里提问。
- 为回答中的每个事实找到原文位置,确认是否有足够条件。
- 对没有答案的交通费问题,检查是否保留未知。
请仅依据当前选择的课程资料回答:
活动地点、场地容量分别是什么?
正式人数怎样统计?讲师交通费是多少钱?
每项保留来源,资料不足就说明不足,不补写成事实。
完成标准
提交全文路线和检索路线的输入、片段与答案。能画出问题、召回内容、最终回答的关系,不能只保存最终回复。
参考解释
当前地点为 301 室,容量 30 人;正式人数筛选已确认并按 participant_id 去重;交通费未提供。若没找到规则,应先查看规则是否已处理和能否被召回,不立即猜统计口径。
实验 E18 比较检索方式和结果顺序
准备
固定五个问题:原文词汇、口语改写、编号规则、需要条件组合的问题和一个无答案问题。使用同一资料与分块。
操作步骤
- 在关键词起点下逐题测试,记录正确来源是否出现、片段内容和位置。
- 配置可用的嵌入模型并完成所需索引,使用完全相同的问题复测。
- 将结果分别记为命中、遗漏或来源错误,不把任意片段当成正确召回。
- 有可用重排序服务时,单独启用,保持其他条件不变,再复测。
- 记录排序变化和额外等待,说明哪些问题改善、哪些没有。
| 问法 | 期望找到的资料 |
|---|---|
| 活动地点 | 当前说明的地点字段 |
| 这间屋子最多坐多少人 | 当前容量与场地说明 |
| R02 规定了什么 | 报名规则中的去重条款 |
| 同一个人报了两次,算几位正式参与者 | R01、R02 的条件 |
| 住酒店最多报多少 | 不在资料范围内 |
完成标准
形成逐题召回对照。没有嵌入或重排序服务时先完成关键词部分,其他部分明确留待实际调用,不伪造提升。
参考解释
语义检索可能改善改写问法,但不保证每个问题都更好。无答案的问题应保持范围限制,不能为了产生召回而把别的活动费用当成答案。
实验 E19 定位一次依据使用失败
操作步骤
- 查看报名规则正文和实际分块,确认条件与结论是否一起可读。
- 若确有分块问题,只改大小或重叠中的一项,对已有资料重新索引后复测。
- 恢复基线,单独调 Top K,记录是否补齐条件或增加无关内容。
- 加入旧版活动说明,要求回答先列版本关系再采用当前安排。
- 使用两个未标优先关系的冲突反例,检查是否请求确认,而不是按文件名或想象猜最新。
- 为每轮写明问题所在层、改变条件、片段变化和答案核验。
完成标准
能定位“资料缺失、解析错误、片段缺条件、召回遗漏、版本误用、生成误解”中的具体问题。没有可复现的分块问题时,如实记录,不人为声称改善。
参考解释
当前 v2 明确取代 v1,因此采用 301 室、30 人。两份无版本优先关系的反例应列出冲突并请求确认。只有关键词相同不构成采用旧版数字的依据。
9.5 从助手检索走向 Agent 检索
助手问答可以由你选择资料范围并发出问题。进入 Agent 后,它可能在多步任务中选择何时搜索、继续读取哪份原文、如何把结果写入产物。知识库仍提供资料,工具与运行环境组织动作。
自检题
01导入知识库是否重新训练了聊天模型?
通常不是。资料经过处理建立可检索表示,提问时取回适用片段并提供给聊天模型。模型参数训练是另一件事,不能从导入回执推断它发生。
02不使用嵌入模型,知识库是否一定不能工作?
不一定。当前官方文档介绍了仅 BM25 关键词检索的起点。加入嵌入模型后可以使用混合检索,具体支持以当前版本确认,不把 RAG 简化为必须做向量化。
03重排序能否修复解析时丢失的正文?
不能创造缺失正文。它重新评价已有候选的顺序,应该先确认资料有答案、解析正确、分块保留了条件,再考虑召回与排序。
04有引用链接,是否说明整条结论都被原文支持?
不说明。要核对来源版本和完整条件。引用可能只支持一部分,甚至与结论无关;检索找到、引用存在和事实成立应分别检查。
下一章进入智能体工作,开始追踪从目标到动作的过程。
本章资料:创建知识库、模型与检索设置、与 Agent 一起使用。具体入口与支持按当前版本确认。