
10 从助手到智能体
在助手里,我们逐轮提供问题和资料,讨论怎样得到合适的回答。现在给系统一个更完整的目标:读取活动材料,核对人数,写一份文件,并在出错时修订。
这需要将理解与动作连接起来。Agent 的运行环境组织模型调用、工具执行、上下文和任务状态,让多步工作有机会连续推进。
10.1 先定义一件可以检查的工作
“帮我筹备活动”太宽。一个适合开始的任务是:只读指定的活动说明、报名规则和 CSV,生成一份新的 Markdown 简报,保留事实、口径和未知事项。
输入在哪里,允许改变什么,成果保存哪里,怎样才算完成,都应明确。模型不能凭你心里的标准完成工作。
10.2 模型和运行环境各做什么
模型根据当前输入生成回答或提出下一步动作。运行环境把工具说明提供给模型,执行允许的动作,接收结果,再为后续调用组织输入。
文件不是因为模型写出“已保存”就出现在磁盘上。需要实际写入动作。写入动作成功后,也还要检查内容是否符合任务。
10.3 Agent 任务与工作目录
Agent 可以保存固定角色、模型和长期能力配置。每个任务组织一次连续的工作记录。工作目录帮助定位文件和任务现场。
同一个 Agent 可以处理不同任务,但输入事实应按任务区分。角色或权限范围显著不同,可以使用独立 Agent,避免把客户、项目或案例材料混在一起。
课程使用专用 Agent 和合成目录。任务中明确只读 materials,成果写入 output;不要读取 answers 来代替独立统计,也不要把真实业务目录作为实验现场。
10.4 运行模式不是模型名称
官方文档列出 Claude Agent、Pi、DeepSeek Harness 等运行模式,它们支持的模型分工、权限和部分能力不同。创建时选择的模式,会影响后续可配置项。
本机 2.1.6 的实际创建界面显示 Claude Agent 与 Pi 两项;本轮选用 Claude Agent,保留默认“智能批准”。界面没有出现的其他模式,不写成已经在本机测试过。
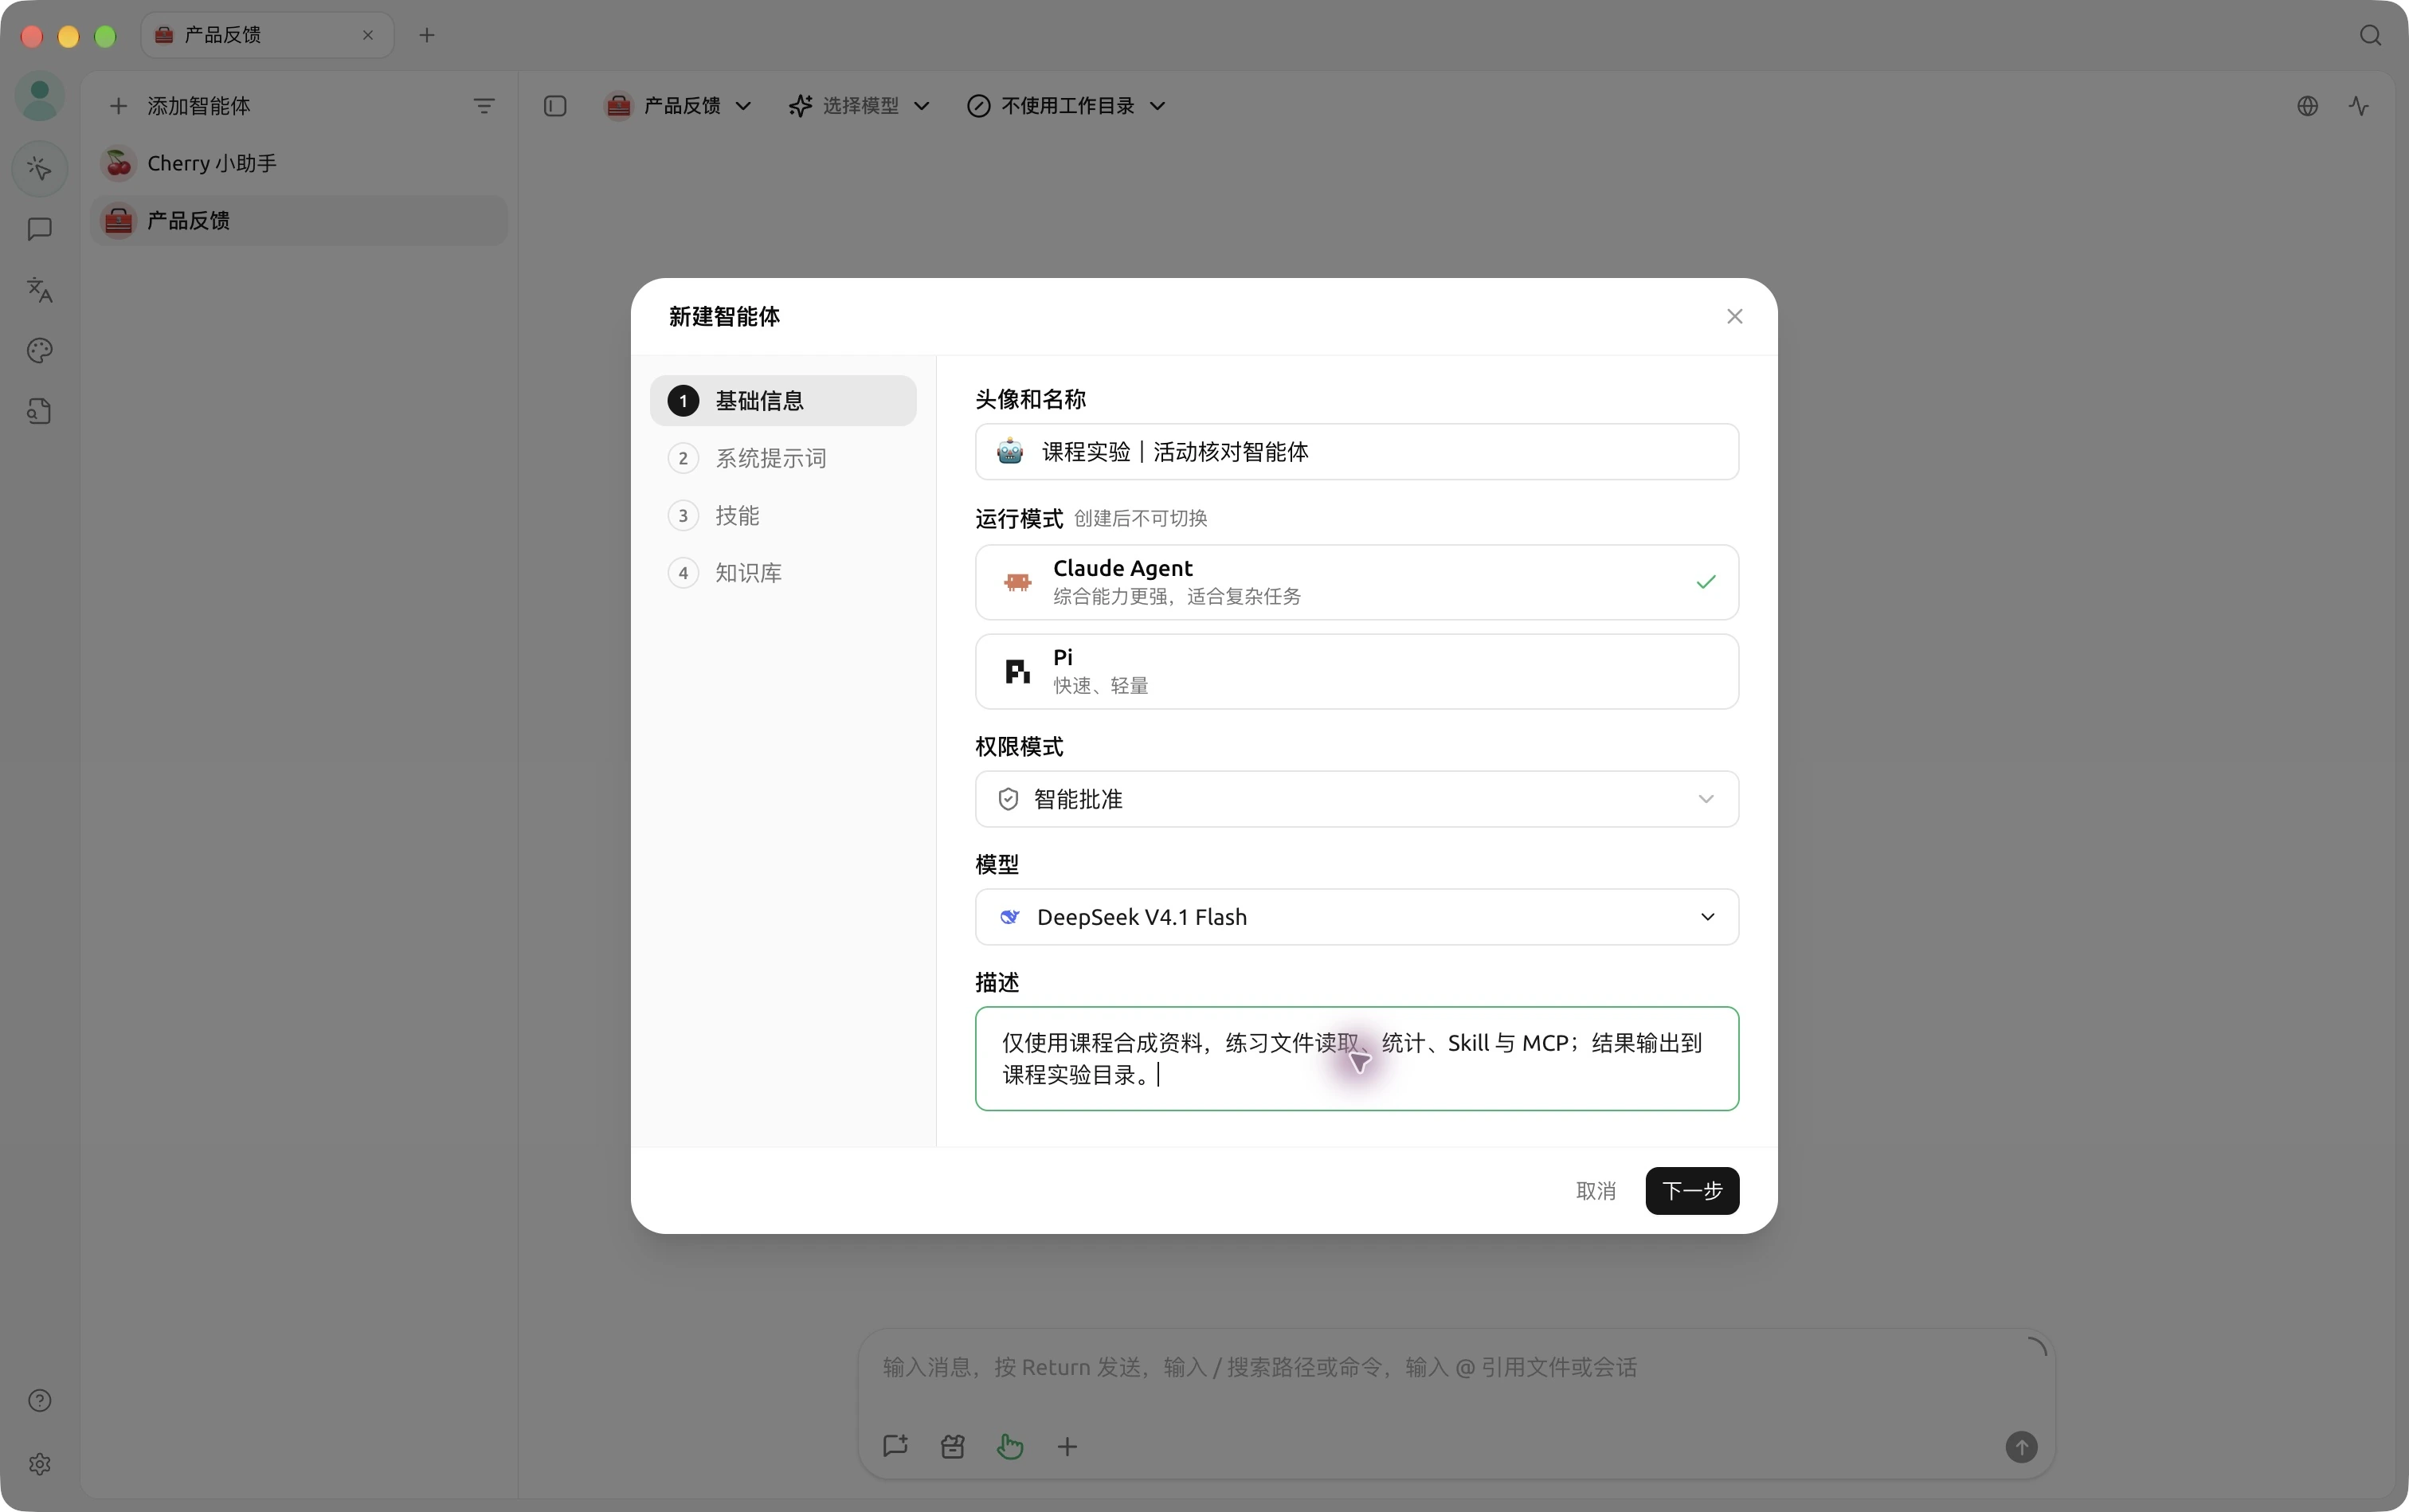
不要把另一种模式的菜单机械搬过来。先选择兼容当前可用模型、经过课程预演的模式,再逐步增加能力。创建 Agent 与模型分工
实验 E20 对照讨论与执行
准备
课程助手和课程专用 Agent;解压素材包,保留原件。工作目录只使用练习包,不绑定私有知识库。
操作步骤
- 在普通对话里提供当前说明、规则和报名表,请它给出统计方法与简报内容。
- 记录实际输出形式及是否发生工具动作。不要预设普通对话必定不能执行。
- 在“工作”中选择课程 Agent 和练习目录,提交下面的文件任务。
- 查看可见的工具动作,确认读取、统计和写入分别发生到哪里。
- 打开实际新文件,核对正式人数、容量和未知信息。
- 追加“只改标题”,检查实际修改和无关内容保留。
请只读取 materials/activity-current.md、materials/registration-rules.md
和 materials/registrations.csv,不读取 answers。

按规则核对活动安排与正式人数,生成 output/activity-brief-v1.md。
报告分为:当前事实、人数口径、冲突与未知、建议。
保留来源;原材料不修改。写完回读检查。
无法读取或写入时说明实际错误,不宣称已经完成。
完成标准
比较的是实际过程,而不是“Chat”与“Agent”名称。文件存在、内容正确和定向修订分别检查。没有可用 Agent 环境时,记录前置条件,不能用一段文件内容冒充已写入。
参考解释
基准正式人数为 9,容量 30,剩余 21。需要使用已确认状态和 participant_id 去重。赞助方、交通费与电话仍未知。原材料与 answers 不应被改写或当成计算依据。
实测:工具跑通之后,仍要检查范围与数字
课程智能体实际经历了“路径失败—查找资料—范围偏离—纠正—请求写入批准—生成报告”。首次输入把路径写错了;修正后,Agent 又将另一个实验的容量变更读入,先算出容量 8、剩余 −1。限定本轮只用当前说明、规则与 CSV 后,它才回到容量 30、正式 9、剩余 21。
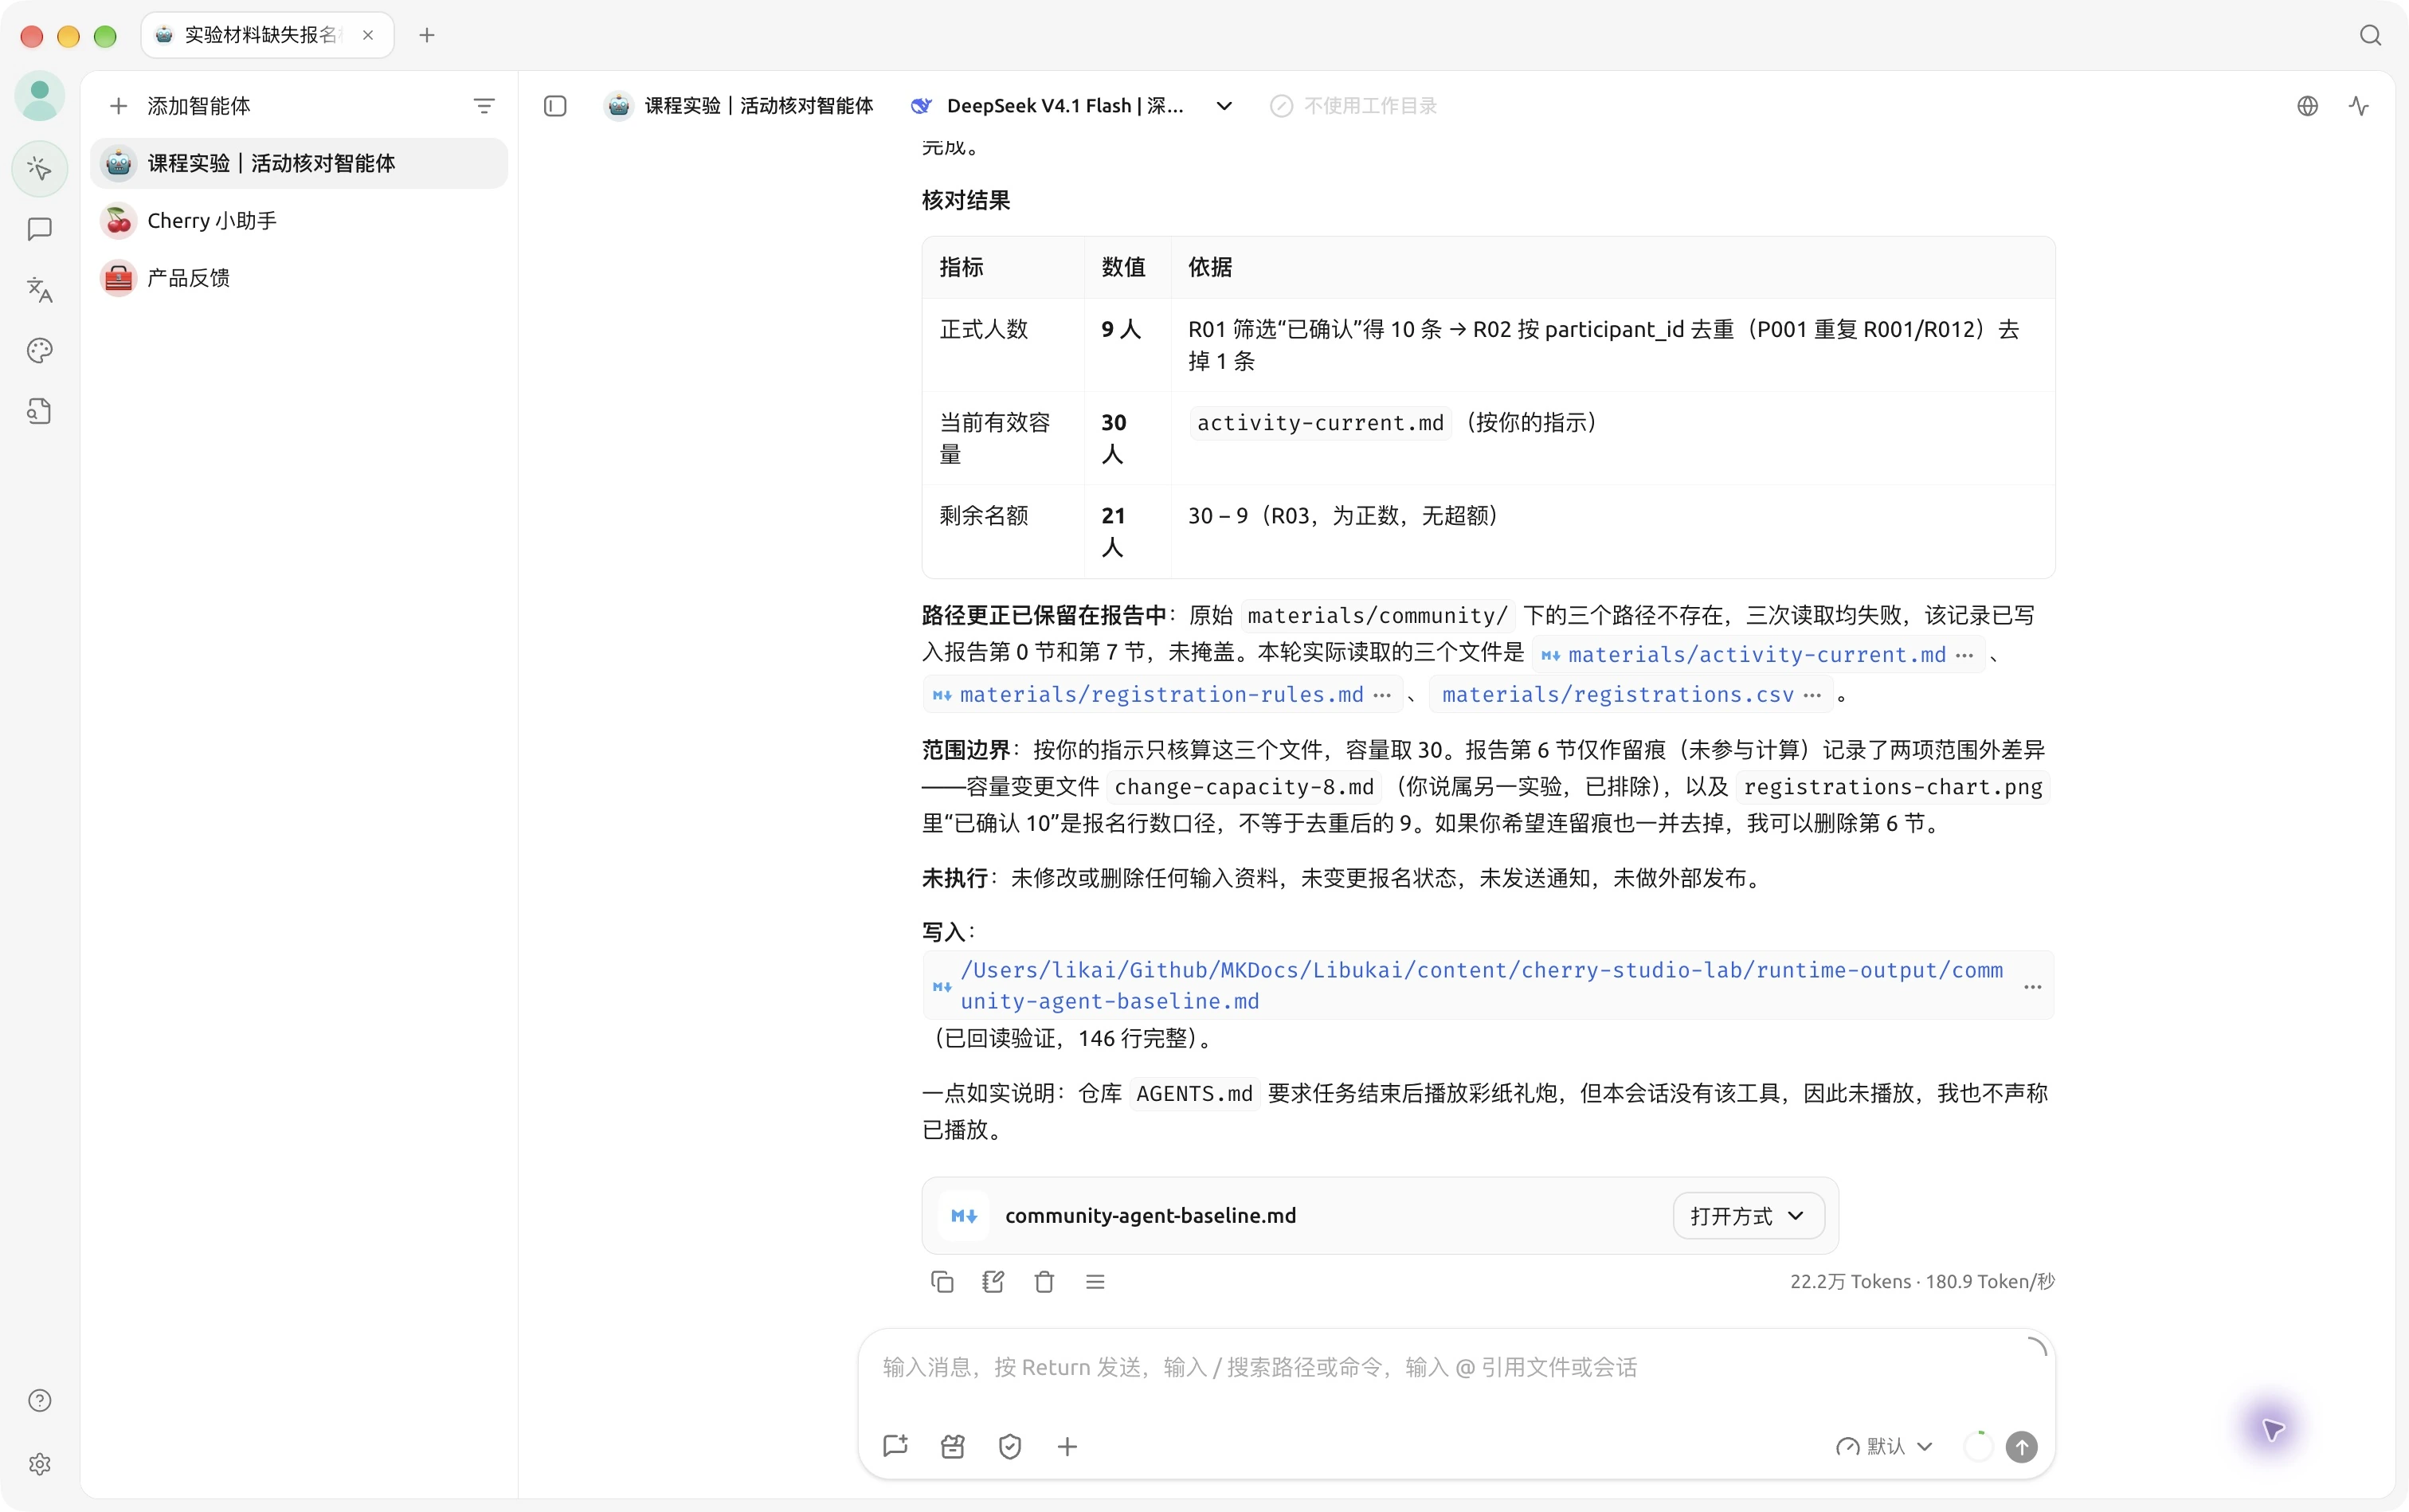
磁盘上的新报告确实存在,三个核心数字与原表一致。但报告把“12 条数据记录加表头”写成了含混的“共 12 行(含表头 1 行 + 记录 12 行)”,并把 R05 摘要缩短到只剩免费说明。这些细节提醒我们:写入成功、核心数字正确与全文无遗漏,仍是不同的检查项。
本轮使用准确的绝对路径执行,界面仍显示“不使用工作目录”;不能把它当作工作目录绑定已成功的证据。学习时应按自己的解压位置指定路径,先确认输入文件真实存在。
实验 E21 追踪执行循环和运行模式
操作步骤
- 记录当前模式、模型、固定要求、能力与权限,不导出凭据。
- 提交读取、统计、写文件的短任务。
- 在可见轨迹中标出“模型提出动作—实际执行—结果或错误—下一步”,把计划文字另列。
- 观察后续动作是否根据真实反馈调整,而不是只重复原计划。
- 有共同兼容模型且条件可比时,用另一专用模式重复小任务;否则只比较文档支持的配置。
- 将文档说明与实际观察分开,不把配置差异全部归因于模型能力。
完成标准
画一条包含真实动作和反馈的任务轨迹。可见的思考文本不是模型内部全过程的独立记录;工具轨迹也不证明所有不可见细节。
参考解释
同一模型可以被不同运行环境组织。差异可能来自工具、权限、输入和运行策略。比较需要记录这些条件,不能仅从一次结果推出某种模式总体最好。
自检题
01一段详细计划是否说明任务已经执行?
不是。计划表达准备做什么;实际动作需要工具调用或其他执行证据,成果还要通过真实文件和数据检查。
02为什么同一个模型在不同 Agent 环境中可能表现不同?
工具、上下文组织、权限、状态管理和运行策略可能不同。模型只是其中一个部件,需要把这些配置和观察分开记录。
03助手和 Agent 的区别是否就是有没有工具按钮?
不能只看按钮。部分对话也可调用工具;Agent 侧重围绕目标、工作目录和多步反馈组织持续执行。应比较实际工作过程。
04指定工作目录是否自动保证只能访问这个目录?
不能普遍保证。目录告诉系统任务现场和文件位置,技术隔离与权限边界要按引擎确认。还应在任务中限制资料与动作范围,并检查实际轨迹。
下一章深入工具怎样赋予行动能力,把“它做了什么”拆成可追踪的输入和返回。